iptables 详解:从原理、规则到 NAT 与实战
1. 什么是 iptables
1.1. iptables 是什么
iptables 是 Linux 系统中用于管理网络数据包过滤和处理规则的工具。它运行在用户空间,负责配置和维护防火墙规则,而真正对数据包进行检查和处理的是 Linux 内核中的 Netfilter 机制。通过 iptables,管理员可以告诉 Linux:哪些网络数据包允许通过,哪些需要拒绝或丢弃,以及某些数据包需要进行什么样的处理。
简单来说,iptables 可以理解为 Linux 网络防火墙的一套规则管理工具。管理员通过命令添加规则,Linux 内核根据这些规则检查经过网络协议栈的数据包,并按照规则指定的动作处理它们。
1.2. iptables 能做什么
iptables 最常见的用途是控制网络流量。例如,可以允许 SSH、HTTP、HTTPS 等指定端口的连接,同时禁止其他不需要的访问;也可以根据源 IP、目标 IP、协议、端口等条件限制网络访问。此外,iptables 还支持 NAT(网络地址转换)、端口转发、数据包标记以及网络流量日志等功能。
因此,iptables 不只是简单的“端口开关”。在 Linux 服务器、网关、路由器以及各种网络服务中,它可以承担访问控制、防火墙、NAT 和流量处理等多种角色。
1.3. iptables 是如何工作的
iptables 的基本工作方式可以概括为:数据包经过 Linux 网络协议栈时,依次经过相应的处理位置,iptables 根据预先配置的规则检查数据包是否满足指定条件,如果匹配,就执行规则规定的动作。例如,一条规则可以匹配“TCP 协议、目标端口为 22”的数据包,然后允许这些数据包通过。
后续章节会进一步介绍数据包在 Linux 内核中的实际处理路径,以及 Table、Chain、Rule、Match 和 Target 之间的关系。
1.4. iptables 能解决哪些实际问题
在实际运维中,iptables 最常见的用途就是控制服务器应该接受哪些网络连接。例如,一台 Web 服务器可以只开放 80、443 端口,并限制 SSH 只允许指定网络访问;一台数据库服务器可以禁止来自公网的直接访问;一台网关服务器则可以通过 NAT 和端口转发,让内部网络中的服务能够被其他网络访问。
除此之外,iptables 还可以用于限制特定 IP 的访问、记录网络连接、实现简单的流量控制,以及配合 Linux 的路由机制完成更加复杂的网络转发方案。后面的章节将通过实际案例逐步介绍这些功能,而不是一开始把所有概念全部展开。
2. Linux 网络数据包处理流程
在写任何 iptables 规则之前,先把数据包在内核里的真实路径搞清楚,比背一百条命令更重要,以下是一张经典的网络数据包处理流程图,理解并建立数据包模型对于掌握iptables的原理以及使用非常关键, 整个过程可用下面这张图完整表示(与附件流程图完全对应)。
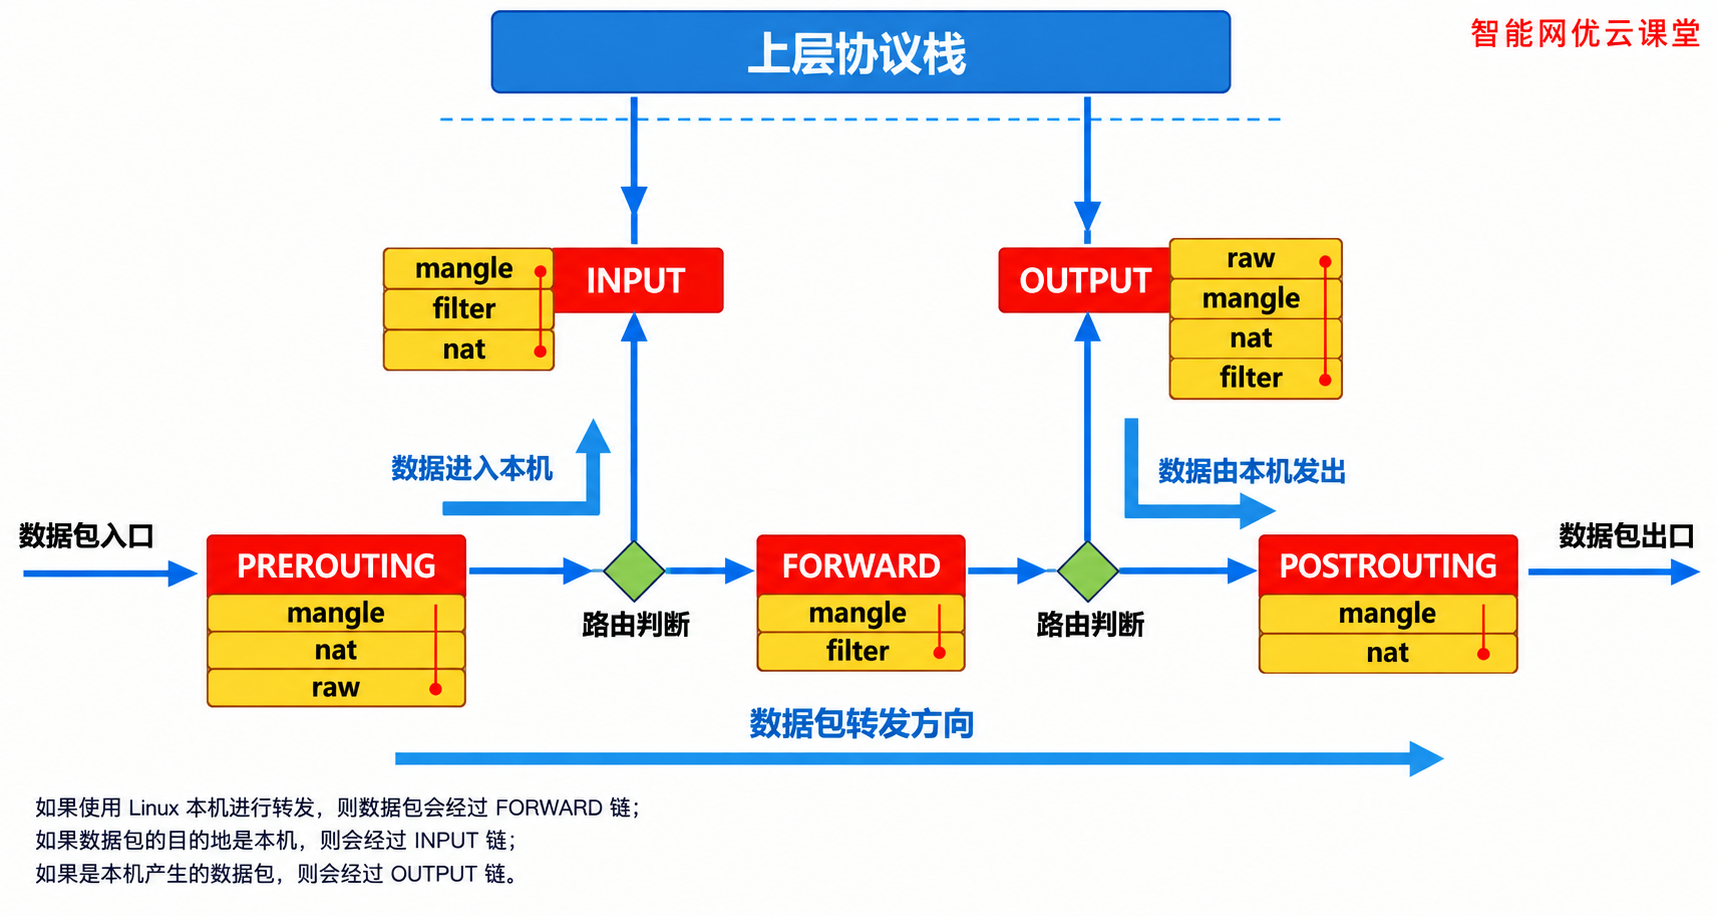
Netfilter 在内核中定义了五个关键钩子(Hook),对应 iptables 的五条内置链:
| 链名 | 触发时机 | 主要用途 |
|---|---|---|
| PREROUTING | 包刚进入网卡后、路由判断前 | DNAT、连接跟踪、mangle |
| INPUT | 确认是发给本机的包 | 本机防火墙(filter) |
| FORWARD | 确认需要转发的包 | 转发控制(路由器/网关) |
| OUTPUT | 本机进程产生的包 | 本机发出流量控制 |
| POSTROUTING | 包即将离开本机前 | SNAT / MASQUERADE |
下面按路径详细拆解。
2.1. 一个数据包进入 Linux 后发生了什么
数据包从网卡进来后,内核严格按照以下顺序处理:
进入 PREROUTING
最先经过。这里做目的地址转换(DNAT)、连接跟踪、包修改等。路由判断(Routing Decision)
内核检查目的 IP:- 是本机 IP → 走向 INPUT
- 不是本机 IP → 走向 FORWARD(必须已开启
ip_forward)
本机处理 or 转发
- 本机包:INPUT → 上层协议栈
- 转发包:FORWARD → 再次路由判断 → POSTROUTING → 离开
本机主动发出的包
上层协议栈 → OUTPUT → 路由判断 → POSTROUTING → 离开
2.2. PREROUTING
位置:数据包入口后的第一站,路由判断之前。
支持的表(从上到下优先级):
rawmanglenat
核心作用:
- 目的地址转换(DNAT)
- 连接跟踪(conntrack 在此建立)
- 修改 TTL、TOS、标记包等
典型场景:
- 公网端口映射到内网服务
- 透明代理(把 80/443 导向本地代理)
实验验证:
1 |
|
验证:
1 |
|
原理点:PREROUTING 发生在路由判断之前,所以这里改的是目的地址。改完后内核才会根据新的目的地址决定走 INPUT 还是 FORWARD。
2.3. INPUT
位置:路由判断后,确认是发给本机的数据包。
主要作用:
- 决定是否允许这个包进入本机上层协议栈
- 本机防火墙的核心防线
常用表:
- mangle
- filter(最常用)
- nat(CentOS 7+ 支持,CentOS 6 不支持,图中因此用灰色标注)
典型场景:
- 只允许特定 IP 访问 SSH(22 端口)
- 限制本机某服务只允许内网访问
- 防暴力破解、限速等
实验验证:
1 |
|
验证:
1 | # 从允许网段访问 → 成功 |
运维实战经验:
INPUT 链的默认策略建议设为 DROP,然后只放行明确需要的流量。这是最基础也是最有效的安全实践。
2.4. FORWARD
位置:路由判断后,确认不是发给本机,需要转发出去的数据包。
主要作用:
- 控制转发流量(路由器、网关、容器宿主机、K8s 节点等场景的核心)
常用表:
- mangle
- filter
前提条件(非常重要):
1 |
|
如果不开启,包即使走到 FORWARD 链,最终也会被内核丢弃。
典型场景:
- 作为网关时,控制内网访问外网的权限
- Docker / K8s 场景下控制容器间通信
- 多网卡服务器做策略路由转发
实验验证:
1 |
|
2.5. OUTPUT
位置:本机进程产生的数据包,在路由判断之前。
主要作用:
- 控制本机主动发出的流量
- 做本机源地址伪装、限制本机访问某些地址等
常用表:
- raw
- mangle
- nat
- filter
典型场景:
- 限制本机只能访问特定外网地址
- 本机服务访问外部时做 SNAT(较少见,通常放在 POSTROUTING)
- 防止本机被植入后门后主动外联
实验验证:
1 |
|
2.6. POSTROUTING
位置:数据包即将离开本机之前(无论是转发的还是本机产生的)。
主要作用:
- 源地址转换(SNAT / MASQUERADE)
- 最后一次修改包头的机会
常用表:
- mangle
- nat(重点做 SNAT)
典型场景:
- 内网机器通过网关访问外网时,把源地址改成网关的公网 IP
- Docker 容器访问外网时的地址伪装
实验验证(最经典的 MASQUERADE):
1 |
|
选择建议:
- 公网 IP 固定 → 用 SNAT
- 公网 IP 动态(拨号/DHCP)→ 用 MASQUERADE
验证方法:
1 |
|
注意:
SNAT 需要指定固定的源 IP,适合公网 IP 固定的场景。
MASQUERADE 会自动使用出口网卡的当前 IP,适合动态公网 IP(拨号、DHCP)场景。
理解了这张图,后面写任何规则时,你都会先问自己一个问题:
“这个包现在走到哪条链了?”
3. iptables 的表与链
iptables 的核心由 表(table)、链(chain) 和 规则(rule) 三层组成。
- 表:定义“做什么类型的操作”(过滤、地址转换、修改包头等)
- 链:定义“在数据包的哪个位置做操作”(PREROUTING、INPUT……)
- 规则:具体的匹配条件 + 动作
理解它们之间的关系,是写对规则的前提。
3.1. filter 表
定位:默认表,也是最常用的表。专门负责包过滤(允许 / 拒绝)。
支持的链:
INPUT:控制进入本机的数据包FORWARD:控制转发的数据包OUTPUT:控制本机发出的数据包
常用动作:
ACCEPT:允许通过DROP:直接丢弃(不回应)REJECT:拒绝并返回错误信息(更友好,但会暴露主机存在)
典型场景:
- 本机防火墙(只允许特定端口访问)
- 网关转发控制(限制内网访问外网)
- 防止端口扫描、暴力破解
实验验证:
1 | # 查看 filter 表规则(默认就是 filter,可省略 -t filter) |
运维实战建议:
filter 表的默认策略(Policy)建议设为 DROP,然后只放行明确需要的流量。这是生产环境最基础的安全实践。
3.2. nat 表
定位:负责网络地址转换(Network Address Translation)。
支持的链:
- PREROUTING:目的地址转换(DNAT),发生在路由判断前
- INPUT:对本机包做地址转换(CentOS 7+ 支持,CentOS 6 不支持)
- OUTPUT:对本机发出的包做地址转换
- POSTROUTING:源地址转换(SNAT / MASQUERADE),发生在包离开前
常用动作:
- DNAT:修改目的地址
- SNAT:修改源地址(需指定固定 IP)
- MASQUERADE:自动使用出口网卡当前 IP 做源地址伪装(适合动态公网 IP)
- REDIRECT:重定向到本机其他端口(透明代理常用)
典型场景:
- 端口映射(公网 80 → 内网 8080)
- 内网通过网关访问外网(MASQUERADE)
- 透明代理
实验验证:
Bash
1 | # DNAT:公网 80 映射到内网 192.168.1.100:8080 |
原理点:
nat 表只在新建连接的第一个包上生效,后续包由连接跟踪(conntrack)自动处理,因此性能较好。
3.3. mangle 表
定位:负责修改数据包
- mangle 在英文里有 “弄乱、损坏、篡改、修改” 的意思。在 iptables 语境中,mangle 最好理解成“修改/调整数据包属性”,而不是字面上的“弄乱”。
mangle为什么不叫modify?这是一个比较有意思的问题。modify 是比较中性的修改,而 mangle 在网络工程历史语境里表达的是:对数据包进行某种“特殊处理/篡改”,使它携带不同的属性或按照不同方式被处理。尤其早期 Netfilter/iptables 的设计中,mangle 表承担的是一组比较杂的 packet alteration 功能,而不是一个单一目的。例如:TTL、TOS、MARK、CONNMARK、DSCP、ECN;这些操作很难用一个特别具体的名字概括。
因此使用了 mangle 这个比较宽泛的术语。- 很多初学者看到 mangle,会以为:mangle = 修改 IP 包里面的数据。其实不是,它更多是在修改或者设置 Linux 内核处理这个数据包时使用的属性。
- iptables 的 mangle 操作主要针对网络层/内核处理相关属性。而真正修改 TCP/UDP Payload,并不是 mangle 表的主要设计目的。
支持的链(最全):
- PREROUTING
- INPUT
- FORWARD
- OUTPUT
- POSTROUTING
常用动作:
- TOS:修改服务类型
- TTL:修改生存时间
- MARK:给包打标记(后续可被 ip rule、tc 等使用)
- SECMARK:安全标记
- TCPMSS:修改 TCP 最大段大小(解决某些 VPN / PPPoE MTU 问题)
典型场景:
- 策略路由(根据标记走不同路由表)
- 流量整形 / QoS
- 解决 PPPoE 拨号 MTU 问题
- 修改 TTL 隐藏跳数
实验验证:
Bash
1 | # 给来自 192.168.1.0/24 的包打标记 100 |
运维提示:
mangle 表使用频率远低于 filter 和 nat,但在复杂网络(多出口、策略路由、QoS)中几乎不可或缺。
3.4. raw 表
定位:优先级最高的表,主要用来决定是否跳过连接跟踪。
支持的链:
- PREROUTING
- OUTPUT
常用动作:
- NOTRACK(或 CT –notrack):不对匹配的包做连接跟踪
典型场景:
- 高流量服务器上,对不需要状态检测的流量(如大量 DNS 查询、日志上报)关闭连接跟踪,降低 conntrack 表压力
- 某些特殊协议不希望被跟踪
实验验证:
1 | # 对所有到达 53 端口的 UDP 包不做连接跟踪 |
原理点:
连接跟踪会消耗内存和 CPU。当服务器并发连接极高时,合理使用 raw 表可以明显降低负载。
3.5. security 表
定位:用于强制访问控制(Mandatory Access Control),与 SELinux 配合使用。
支持的链:
- INPUT
- FORWARD
- OUTPUT
常用动作:
- SECMARK:设置安全上下文标记
- CONNSECMARK:设置连接的安全标记
使用频率:
在普通运维场景中几乎很少直接操作,主要出现在启用了 SELinux 的强制模式下,由系统自动管理。
建议:
除非你明确在做 SELinux 相关的安全策略,否则日常写规则时可以忽略这个表。
3.6. 不同表有哪些链
下表清晰展示了每个表支持的链(✓ 表示支持):
| 链 \ 表 | raw | mangle | nat | filter | security |
|---|---|---|---|---|---|
| PREROUTING | ✓ | ✓ | ✓ | ||
| INPUT | ✓ | ✓* | ✓ | ✓ | |
| FORWARD | ✓ | ✓ | ✓ | ||
| OUTPUT | ✓ | ✓ | ✓ | ✓ | ✓ |
| POSTROUTING | ✓ | ✓ |
*注:nat 表的 INPUT 链在 CentOS 7 / 较新内核中才支持,CentOS 6 不支持。
优先级顺序(同一钩子点上,表的执行顺序):
text
1 | raw → mangle → nat → filter → security |
也就是说,raw 表最先执行,security 表最后执行。
3.7. 表、链、规则之间的关系
可以用一句话概括:
表决定“做什么”,链决定“在哪里做”,规则决定“对谁做、怎么做”。
更具体的关系如下:
- 一个表可以包含多条链
例如 filter 表有 INPUT、FORWARD、OUTPUT 三条链。 - 一条链属于某个表
例如 iptables -t nat -A PREROUTING … 明确指定了表和链。 - 规则按顺序挂在链上
数据包到达某条链后,会从上到下依次匹配规则,一旦匹配成功就执行对应动作(并通常停止继续匹配,除非使用了 -j 跳转到自定义链)。 - 执行顺序由两个维度决定:
- 位置维度(链的顺序):PREROUTING → INPUT/FORWARD → OUTPUT → POSTROUTING
- 类型维度(表的优先级):raw → mangle → nat → filter → security
完整执行流程示例(以一个进入本机的包为例):
text
1 | 数据包进入网卡 |
运维实战口诀:
- 想过滤(允许/拒绝)→ 用 filter 表
- 想改地址(DNAT/SNAT)→ 用 nat 表
- 想改包头或打标 → 用 mangle 表
- 想跳过连接跟踪 → 用 raw 表
- 写规则前先问自己:
- 这个包现在走到哪条链了?
- 我需要的是过滤、转换还是修改?
把这三点想清楚,规则就不会写错位置。
4. iptables 与 Netfilter 的关系和交互
很多运维同学把 iptables 当成“防火墙工具”来用,但真正决定数据包命运的,是内核里的 Netfilter 框架。
iptables 只是用户空间的配置工具,真正干活的是内核。
理解它们之间的关系,才能真正搞清楚:
规则为什么生效、为什么不生效、为什么有时候会“丢包”、为什么性能会受影响。
以下是根据个人理解画出的 iptables 与 Netfilter 的交互图,有不准确的还望留言指正。
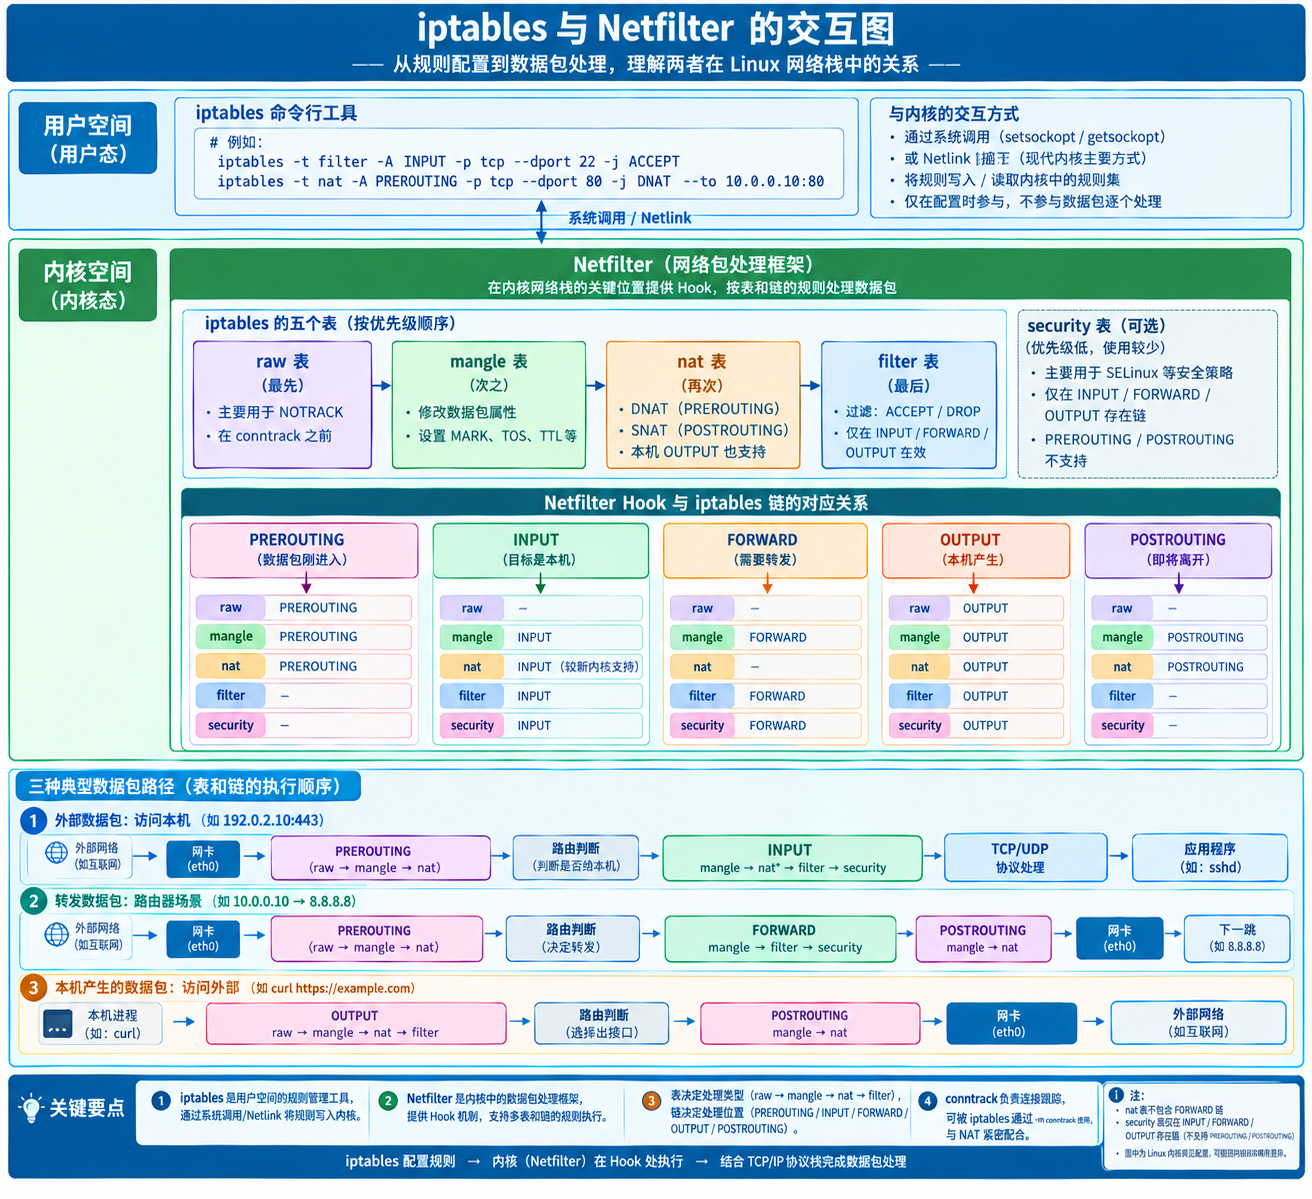
4.1. iptables 与 Netfilter 是什么关系
一句话总结:
Netfilter 是内核框架,iptables 是用户空间配置工具。
| 组件 | 所在位置 | 职责 |
|---|---|---|
| Netfilter | 内核空间 | 提供钩子(Hook)、表、链、规则执行引擎 |
| iptables | 用户空间 | 向内核下发规则、查看规则、管理链 |
| iptables 命令 | 用户进程 | 解析命令,通过 netlink / setsockopt 与内核通信 |
类比:
- Netfilter 像是高速公路上的检查站系统
- iptables 像是交警用来设置检查规则的电脑
没有 Netfilter,iptables 什么也做不了;没有 iptables,运维人员很难方便地配置 Netfilter。
4.2. Linux TCP/IP 协议栈与 Netfilter
Linux 网络协议栈处理数据包的大致路径如下:
1 | 网卡驱动 → 协议栈入口 → 路由决策 → 传输层(TCP/UDP)→ 应用层 |
Netfilter 在协议栈的关键位置插入了钩子(Hook),让内核可以在这些位置“拦截”数据包并执行规则。
目前最重要的五个钩子位置是:
- NF_INET_PRE_ROUTING(对应 PREROUTING)
- NF_INET_LOCAL_IN(对应 INPUT)
- NF_INET_FORWARD(对应 FORWARD)
- NF_INET_LOCAL_OUT(对应 OUTPUT)
- NF_INET_POST_ROUTING(对应 POSTROUTING)
这些钩子是 Netfilter 与协议栈交互的核心接口。
4.3. Netfilter Hook 与 iptables 链
iptables 的五条内置链,本质上就是对 Netfilter 五个钩子的封装:
| Netfilter Hook | iptables 链 | 触发时机 |
|---|---|---|
| NF_INET_PRE_ROUTING | PREROUTING | 包进入后、路由判断前 |
| NF_INET_LOCAL_IN | INPUT | 确认是发给本机的包 |
| NF_INET_FORWARD | FORWARD | 确认需要转发的包 |
| NF_INET_LOCAL_OUT | OUTPUT | 本机进程产生的包 |
| NF_INET_POST_ROUTING | POSTROUTING | 包即将离开本机前 |
关系本质:
- 用户写的是 iptables 链规则
- 内核真正执行的是注册在对应 Hook 上的回调函数
- 规则最终会转换成 Hook 上的“匹配 + 动作”逻辑
4.4. 一条 iptables 规则是如何进入内核的
当你执行一条命令:
1 | iptables -A INPUT -p tcp --dport 22 -j ACCEPT |
完整过程如下:
- 用户空间解析
iptables 命令行工具解析参数,生成规则结构。 - 与内核通信
通过 setsockopt 或 netlink(较新版本)把规则发送给内核。 - 内核接收并转换
内核的 iptables 模块(ip_tables)接收规则,转换成内部数据结构。 - 挂载到对应链
规则被插入到指定表的指定链中(按顺序)。 - 注册到 Hook
最终这条规则会作为回调函数的一部分,注册到对应的 Netfilter Hook 上。
之后,每当有数据包经过该 Hook,内核就会依次匹配这些规则。
4.5. 一个数据包如何经过 Netfilter 与 iptables
以一个进入本机的 TCP 包为例,完整路径如下:
- 网卡收到数据包
- 进入 NF_INET_PRE_ROUTING 钩子
→ 依次执行 raw → mangle → nat 表的 PREROUTING 链 - 路由判断(是本机包)
- 进入 NF_INET_LOCAL_IN 钩子
→ 依次执行 mangle → nat(如支持)→ filter → security 表的 INPUT 链 - 如果全部 ACCEPT,则交给上层协议栈(TCP)
- 最终到达监听 22 端口的 sshd 进程
如果中途任何一条规则执行了 DROP 或 REJECT,包就会在这里被终结,不会继续往后走。
4.6. iptables 表如何参与数据包处理
不同表在同一个钩子上的执行顺序是固定的:
1 | raw → mangle → nat → filter → security |
这意味着:
- raw 表最先执行:可以决定是否跳过连接跟踪
- mangle 表次之:可以先修改包或打标记
- nat 表再次:做地址转换(只对新建连接的第一个包生效)
- filter 表较后:做最终的允许/拒绝决策
- security 表最后:配合 SELinux 做强制访问控制
运维启示:
- 想改地址,用 nat 表
- 想过滤,用 filter 表
- 想先打标记再过滤,把标记动作放在 mangle 表
顺序错了,规则可能永远匹配不到。
4.7. conntrack 在其中扮演什么角色
conntrack(连接跟踪) 是 Netfilter 的核心组件之一,由 nf_conntrack 模块实现。
它的主要作用:
- 记录连接状态
每个连接都会在内核中建立一个 conntrack 条目,记录五元组、状态(NEW、ESTABLISHED、RELATED、INVALID)等。 - 让状态匹配成为可能
规则中的 -m state –state ESTABLISHED,RELATED 就是依赖 conntrack。 - 支持 NAT
NAT 只对连接的第一个包做地址转换,后续包由 conntrack 自动完成映射。 - 性能关键点
高并发场景下,conntrack 表可能成为瓶颈(默认大小有限)。
查看当前连接跟踪:
Bash
1 | # 查看当前跟踪的连接数 |
运维实战:
- 服务器并发极高时,适当调大 nf_conntrack_max
- 对不需要状态检测的流量(如大量 DNS),可用 raw 表的 NOTRACK 跳过跟踪
4.8. iptables 规则究竟在哪里执行
规则真正执行的位置是在内核的 Netfilter Hook 回调中,而不是在用户空间。
具体来说:
- 数据包到达某个 Hook
- 内核调用该 Hook 上注册的所有回调函数
- 回调函数按照表的优先级和链中规则的顺序,依次进行匹配
- 匹配成功后执行对应的 target(ACCEPT、DROP、SNAT 等)
- 根据返回值决定包是继续往后走,还是被丢弃/修改
因此:
- 规则写得再多,只要包没走到对应的 Hook,就永远不会生效
- 规则顺序很重要,因为匹配是从上到下、短路执行的
4.9. iptables-legacy 与 iptables-nft
从内核 3.13 开始,Linux 引入了新的包过滤框架 nftables,并逐渐成为默认后端。
目前存在两套实现:
| 项目 | 说明 |
|---|---|
| iptables-legacy | 传统实现,基于 xtables + ip_tables 模块 |
| iptables-nft | 兼容层,底层调用 nftables |
如何区分当前使用的是哪一套:
Bash
1 | # 查看 iptables 版本信息 |
- 如果输出包含 nf_tables,说明是 iptables-nft
- 如果输出是传统版本,则是 iptables-legacy
主要区别:
| 对比项 | iptables-legacy | iptables-nft |
|---|---|---|
| 后端框架 | xtables | nftables |
| 性能 | 一般 | 更好(规则编译成字节码) |
| 规则语法兼容 | 原生 | 高度兼容,但有少量差异 |
| 未来方向 | 逐渐被淘汰 | 官方推荐方向 |
| 与 firewalld | 旧版使用 | 新版默认使用 |
运维建议:
- 新系统(CentOS 8+、Ubuntu 20.04+)优先使用 iptables-nft 或直接学习 nftables
- 老系统或需要高度兼容的场景,继续使用 iptables-legacy
- 两者规则不能混用,切换时注意清空旧规则
理解了这些,你就不再是“会写规则的人”,而是真正理解防火墙工作原理的人。
5. iptables 基本语法
掌握了表、链和数据包路径后,接下来就是真正动手写规则。
iptables 的命令结构非常规律,只要记住核心框架,绝大多数操作都能快速写出来。
5.1. iptables 命令结构
iptables 的基本命令格式如下:
1 | iptables [-t 表名] 命令 链名 [规则编号] [匹配条件] [-j 动作] |
各部分含义:
| 部分 | 说明 | 示例 |
|---|---|---|
| -t 表名 | 指定表(默认是 filter) | -t nat、-t mangle |
| 命令 | 对规则进行的操作 | -A、-I、-D、-R 等 |
| 链名 | 操作的目标链 | INPUT、PREROUTING 等 |
| 规则编号 | 规则在链中的位置(可选) | 1、3 |
| 匹配条件 | 匹配数据包的条件 | -p tcp –dport 22 |
| -j 动作 | 匹配成功后执行的动作 | -j ACCEPT、-j DROP |
常用命令一览:
| 命令 | 含义 | 示例 |
|---|---|---|
| -A | 追加规则到链尾 | -A INPUT |
| -I | 插入规则到指定位置 | -I INPUT 1 |
| -D | 删除规则 | -D INPUT 3 |
| -R | 替换(修改)规则 | -R INPUT 2 … |
| -L | 列出规则 | -L -n -v |
| -F | 清空链中所有规则 | -F INPUT |
| -P | 设置链的默认策略 | -P INPUT DROP |
| -N | 新建自定义链 | -N MY_CHAIN |
| -X | 删除自定义链 | -X MY_CHAIN |
5.2. 查看规则
最常用的查看命令:
Bash
1 | # 查看 filter 表所有链的规则(默认表) |
参数说明:
- -n:以数字形式显示 IP 和端口(不反查域名,速度更快)
- -v:显示详细信息(包括包计数器和字节数)
- --line-numbers:显示规则编号,方便后续删除或修改
运维建议:
日常排查问题时,一定要加 --line-numbers,否则删除规则时容易删错。
5.3. 添加规则
使用 -A(Append)把规则追加到链的末尾:
Bash
1 | # 允许 192.168.1.0/24 访问本机 22 端口 |
注意:-A 添加的规则优先级最低(在链的最后)。如果前面已经有匹配的规则,后面的规则可能永远不会生效。
5.4. 删除规则
有两种删除方式:
方式一:按规则编号删除(推荐)
Bash
1 | # 先查看带编号的规则 |
方式二:按规则内容删除
Bash
1 | # 必须把匹配条件和动作写完整 |
运维提示:
按内容删除时,规则必须与原规则完全一致,否则会报错。推荐优先使用编号删除。
5.5. 修改规则
使用 -R(Replace)替换指定编号的规则:
Bash
1 | # 把 INPUT 链第 2 条规则替换为新规则 |
注意:
- 必须指定规则编号
- 新规则会完全覆盖旧规则
- 如果只是想调整顺序,更推荐先删除再插入
5.6. 插入规则
使用 -I(Insert)把规则插入到链的指定位置(默认插入到第 1 条):
Bash
1 | # 插入到 INPUT 链的最前面(最高优先级) |
对比 -A 和 -I:
- -A:追加到末尾,优先级最低
- -I:插入到指定位置,可控制优先级
实战经验:
需要优先匹配的规则(如白名单、管理端口)建议用 -I 插到前面。
5.7. 清空规则
Bash
1 | # 清空 filter 表所有链的规则(不改变默认策略) |
危险操作警告:
Bash
1 | # 以下命令会清空所有表的规则,生产环境慎用! |
5.8. 设置默认策略
默认策略(Policy)决定了当数据包没有匹配到任何规则时的行为:
Bash
1 | # 设置 INPUT 链默认拒绝 |
查看当前默认策略:
Bash
1 | iptables -L -n | grep policy |
运维最佳实践:
- INPUT 和 FORWARD 建议设为 DROP
- OUTPUT 通常保持 ACCEPT(除非有严格的出站控制需求)
- 设置默认策略前,务必先放行 SSH 端口,否则可能把自己锁在外面!
5.9. 规则编号
规则编号是定位规则的关键:
Bash
1 | # 查看带编号的规则 |
输出示例:
text
1 | num pkts bytes target prot opt in out source destination |
有了编号后,删除、修改、插入都会非常精准。
5.10. 保存和恢复规则
iptables 规则默认只存在于内存中,重启后会丢失,必须手动保存。
CentOS / RHEL 系统:
Bash
1 | # 安装 iptables-services(如果没有) |
Ubuntu / Debian 系统:
Bash
1 | # 保存规则 |
通用方法(所有发行版可用):
Bash
1 | # 保存 |
运维建议:
- 每次修改规则后,立刻备份一份。
- 重要变更前先 iptables-save > backup_$(date +%F).txt。
- 生产环境推荐使用 iptables-persistent 或 firewalld(如果已切换),避免重启后规则丢失。
6. 常用匹配条件
在前一章中,我们掌握了 iptables 命令的基本结构(表、链、动作以及规则的增删改查)。然而,防火墙的核心能力在于精确识别数据包。只有能够精准筛选出特定流量,后续的 ACCEPT、DROP 或 DNAT 等动作才有意义。
在 Netfilter/iptables 体系中,匹配条件(Matches)分为两大类:
- 基本匹配条件(Generic Matches):内核原生支持,无需加载额外模块即可直接使用(如源/目的 IP、入站/出站接口、协议类型等)。
- 扩展匹配条件(Extended Matches):通过
-m(或--match)显式加载内核扩展模块来使用(如端口范围、IP 地址池、MAC 地址、状态追踪等)。
本节将逐一剖析最常用的匹配条件,帮助你构建精准的数据包过滤规则。
iptables 规则的核心是「匹配条件 + 动作」。
匹配条件写得越精准,规则就越安全、越高效。下面列出最常用、也是生产环境中出现频率最高的匹配条件。
6.1. -s / –source(源地址)
匹配数据包的源 IP 地址。
1 | # 匹配单个 IP |
运维提示:
生产环境中尽量使用网段(/24、/16)而不是单个 IP,便于管理和减少规则数量。
6.2. -d / –destination(目的地址)
匹配数据包的目的 IP 地址。
Bash
1 | # 匹配发往本机某个 IP 的包 |
6.3. -i / –in-interface(入接口)
匹配数据包进入本机的网卡。
Bash
1 | # 只允许从 eth0 进入的包 |
适用链:主要用于 INPUT、PREROUTING、FORWARD。
6.4. -o / –out-interface(出接口)
匹配数据包离开本机的网卡。
Bash
1 | # 只允许从 eth0 出去的包 |
适用链:主要用于 OUTPUT、POSTROUTING、FORWARD。
6.5. -p / –protocol(协议)
匹配协议类型,是使用频率最高的条件之一。
Bash
1 | # 匹配 TCP |
常用协议数值:
- tcp = 6
- udp = 17
- icmp = 1
- all = 0(所有)
6.6. –sport / –source-port(源端口)
匹配源端口(必须配合 -p tcp 或 -p udp)。
Bash
1 | # 匹配源端口为 12345 的 TCP 包 |
注意:客户端主动发起的连接,源端口通常是随机的高端口,生产中较少单独使用 --sport 做严格限制。
6.7. –dport / –destination-port(目的端口)
匹配目的端口,是防火墙规则中最核心的条件之一。
Bash
1 | # 允许 SSH |
6.8. TCP flags(TCP 标志位)
用于匹配 TCP 包头中的标志位(SYN、ACK、FIN、RST 等),常用于防扫描或精细控制。
Bash
1 | # 只允许新连接的 SYN 包(常用) |
常用组合:
- --tcp-flags SYN,ACK,FIN,RST SYN:匹配纯 SYN 包(新连接)
- --tcp-flags ALL NONE:匹配所有标志位都为 0 的异常包(可丢弃)
6.9. ICMP
匹配 ICMP 协议及具体类型。
Bash
1 | # 允许所有 ICMP |
常用 ICMP 类型:
- echo-request(8):ping 请求
- echo-reply(0):ping 响应
- destination-unreachable(3)
- time-exceeded(11)
6.10. multiport(多端口匹配)
一次匹配多个端口,避免写多条规则。
Bash
1 | # 需要加载 multiport 模块 |
限制:最多一次指定 15 个端口。
6.11. iprange(IP 范围匹配)
匹配一个连续的 IP 地址范围(当无法用 CIDR 精确表示时特别有用)。
Bash
1 | # 需要加载 iprange 模块 |
6.12. mac(MAC 地址匹配)
匹配源 MAC 地址,常用于内网精准控制。
Bash
1 | # 需要加载 mac 模块 |
注意:
MAC 地址只在二层(同一广播域)可见,经过路由后会丢失,因此只适合在内网网关或桥接场景使用。
6.13. set / ipset(高效 IP 集合匹配)
当需要匹配大量 IP 或网段时,使用 ipset 是性能最优解(比写几百条 -s 规则高效得多)。
1. 创建并添加 IP 集合:
Bash
1 | # 安装 ipset(如未安装) |
2. 在 iptables 中引用:
Bash
1 | # 匹配集合中的源 IP |
运维实战价值:
- 黑名单/白名单达到几百上千个 IP 时,用 ipset 性能远高于直接写规则。
- 支持动态添加/删除,无需频繁重载 iptables 规则。
- 可与 hash:ip、hash:net、hash:mac 等多种类型配合使用。
本节匹配条件速查:
| 条件 | 常用场景 | 是否需要 -m |
|---|---|---|
| -s / -d | 源/目的 IP | 否 |
| -i / -o | 入/出接口 | 否 |
| -p | 协议 | 否 |
| --sport/–dport | 端口 | 否(需配合 -p) |
| --tcp-flags | TCP 标志位 | 否 |
| --icmp-type | ICMP 类型 | 否 |
| multiport | 多端口 | 是 |
| iprange | IP 范围 | 是 |
| mac | MAC 地址 | 是 |
| set | ipset 集合 | 是 |
把这些匹配条件组合使用,就能写出精准且高效的规则。
7. 常见 Target / 动作
匹配条件决定「哪些包会被选中」,Target(动作)则决定「选中后怎么处理」。
iptables 的动作分为两类:
- 终止类动作:匹配后立即决定包的命运(ACCEPT、DROP、REJECT 等),不再继续匹配后续规则。
- 非终止类动作:匹配后执行某些操作(LOG、MARK 等),然后继续匹配后续规则。
7.1. ACCEPT
含义:允许数据包通过,停止继续匹配当前链的后续规则。
1 | # 允许 SSH 访问 |
特点:
- 最常用的动作之一
- 匹配成功后,包会继续在协议栈中正常处理
- 不会产生任何响应包
7.2. DROP
含义:直接丢弃数据包,不给出任何响应。
Bash
1 | # 丢弃所有来自某 IP 的包 |
特点:
- 静默丢弃,对方会感觉「请求超时」
- 安全性较高(不暴露主机是否存在)
- 对方会重试,可能产生更多流量
适用场景:黑名单、默认拒绝策略、防御扫描。
7.3. REJECT
含义:拒绝数据包,并返回一个错误响应给发送方。
Bash
1 | # 拒绝并返回 TCP RST |
常用 --reject-with 选项:
| 选项 | 含义 | 适用协议 |
|---|---|---|
| tcp-reset | 发送 TCP RST | TCP |
| icmp-port-unreachable | 端口不可达 | 通用 |
| icmp-host-unreachable | 主机不可达 | 通用 |
| icmp-proto-unreachable | 协议不可达 | 通用 |
| icmp-net-unreachable | 网络不可达 | 通用 |
DROP vs REJECT 对比:
| 对比项 | DROP | REJECT |
|---|---|---|
| 是否响应 | 无响应 | 返回错误信息 |
| 对方感受 | 超时 | 立即收到拒绝 |
| 安全性 | 更高(隐蔽) | 较低(暴露主机存在) |
| 推荐场景 | 黑名单、默认策略 | 需要明确告知对方「被拒绝」 |
运维建议:对外服务端口推荐用 DROP,内部管理或调试场景可用 REJECT。
7.4. LOG
含义:将匹配到的数据包信息记录到系统日志,然后继续匹配后续规则(非终止动作)。
Bash
1 | # 记录并带上自定义前缀 |
常用参数:
- --log-prefix “前缀”:日志前缀,方便过滤
- --log-level 数字:日志级别(0-7,默认 4)
- --log-tcp-sequence:记录 TCP 序列号
- --log-tcp-options:记录 TCP 选项
- --log-ip-options:记录 IP 选项
查看日志:
Bash
1 | # CentOS / RHEL |
运维提示:
LOG 规则一定要放在 DROP/REJECT 之前,否则包已经被丢弃就无法记录了。生产环境建议限制日志频率,避免日志爆炸。
7.5. RETURN
含义:停止当前链的匹配,返回到调用链(或上一级链)继续处理。
Bash
1 | # 自定义链中使用 |
使用场景:
- 自定义链中作为「默认返回」动作
- 实现更复杂的逻辑跳转
如果在内置链(如 INPUT)中使用 RETURN,效果等同于该链的默认策略。
7.6. DNAT(目的地址转换)
含义:修改数据包的目的地址(和可选端口),主要用于端口映射和负载均衡。
只能用在 nat 表的 PREROUTING 和 OUTPUT 链。
Bash
1 | # 公网 80 端口映射到内网 192.168.1.100:8080 |
实验验证:
Bash
1 | # 在网关机器上添加规则后,从外部访问网关的 80 端口 |
7.7. SNAT(源地址转换)
含义:修改数据包的源地址,常用于内网主机访问外网时统一出口 IP。
只能用在 nat 表的 POSTROUTING 链。
Bash
1 | # 将内网 192.168.1.0/24 的源地址转换为固定公网 IP |
适用场景:公网 IP 固定的服务器或网关。
7.8. MASQUERADE
含义:动态源地址转换,自动使用出口网卡的当前 IP 作为源地址。
只能用在 nat 表的 POSTROUTING 链。
Bash
1 | # 最经典的内网共享上网规则 |
SNAT vs MASQUERADE:
| 对比项 | SNAT | MASQUERADE |
|---|---|---|
| 源地址 | 需要指定固定 IP | 自动使用出口网卡当前 IP |
| 适用场景 | 公网 IP 固定 | 公网 IP 动态(拨号、DHCP) |
| 性能 | 稍高 | 稍低(每次需获取接口 IP) |
| 推荐程度 | 固定 IP 时优先用 SNAT | 动态 IP 时必须用 MASQUERADE |
运维建议:
能用 SNAT 就用 SNAT,性能更好;只有出口 IP 会变时才用 MASQUERADE。
7.9. MARK
含义:给数据包打上标记(fwmark),供后续的 ip rule、tc(流量控制)、策略路由等使用。
常用在 mangle 表。
Bash
1 | # 给来自某网段的包打标记 100 |
后续使用示例(策略路由):
Bash
1 | # 根据标记选择不同路由表 |
7.10. CONNMARK
含义:对整个连接打标记(而不是单个包),标记会被连接跟踪保存,后续同一连接的包都能继承。
Bash
1 | # 给连接打标记 |
MARK vs CONNMARK:
| 对比项 | MARK | CONNMARK |
|---|---|---|
| 作用对象 | 单个数据包 | 整个连接 |
| 生命周期 | 只影响当前包 | 连接跟踪期间一直有效 |
| 典型用途 | 临时标记、流量分类 | 需要同一连接保持一致标记 |
常见经典组合(恢复连接标记):
Bash
1 | iptables -t mangle -A PREROUTING -j CONNMARK --restore-mark |
本节动作速查:
| 动作 | 类型 | 主要表/链 | 作用摘要 |
|---|---|---|---|
| ACCEPT | 终止 | 所有 | 允许通过 |
| DROP | 终止 | 所有 | 静默丢弃 |
| REJECT | 终止 | 所有 | 拒绝并响应 |
| LOG | 非终止 | 所有 | 记录日志 |
| RETURN | 终止 | 自定义链 | 返回上一级链 |
| DNAT | 终止 | nat/PREROUTING, OUTPUT | 修改目的地址 |
| SNAT | 终止 | nat/POSTROUTING | 修改源地址(固定 IP) |
| MASQUERADE | 终止 | nat/POSTROUTING | 修改源地址(动态 IP) |
| MARK | 非终止 | mangle | 给包打标记 |
| CONNMARK | 非终止 | mangle | 给连接打标记 |
理解这些动作的适用场景和终止/非终止特性后,写规则时就能更精准地控制数据包的命运。
8. 最常见的防火墙规则
前面学会了语法、匹配条件和动作,现在进入真正的实战环节。
以下是生产环境中出现频率最高的防火墙规则,建议直接收藏备用。
8.1. 放行 SSH
最重要也是最危险的规则。写错或顺序不对,可能导致自己被锁在服务器外面。
1 | # 基础放行(不限制来源) |
安全写法(推荐顺序):
1 | # 1. 先放行已建立的连接(防止自己断连) |
血泪教训:
设置 INPUT 默认策略为 DROP 之前,必须先放行 SSH,否则规则一生效,你就连不上服务器了。
8.2. 放行 HTTP/HTTPS
1 | # 放行 HTTP |
只允许特定来源访问网站(例如仅内网或特定办公网):
1 | iptables -A INPUT -p tcp -m multiport --dports 80,443 -s 192.168.0.0/16 -j ACCEPT |
8.3. 禁止某个 IP
Bash
1 | # 直接丢弃某 IP 的所有包 |
批量禁止(推荐使用 ipset):
1 | ipset create blacklist hash:ip |
8.4. 允许某个 IP 访问指定端口
1 | # 只允许 203.0.113.10 访问 3306 端口(MySQL) |
完整安全示例(先允许,后拒绝):
Bash
1 | iptables -A INPUT -p tcp --dport 3306 -s 192.168.1.0/24 -j ACCEPT |
8.5. 限制某个网段
Bash
1 | # 只允许 10.0.0.0/8 网段访问本机 |
8.6. 限制新建连接
使用 state 或 conntrack 模块,只允许已建立的连接,拒绝非法新建连接(有效防御端口扫描和部分攻击)。
Bash
1 | # 允许所有已建立和相关的连接 |
更现代的写法(推荐使用 conntrack):
Bash
1 | iptables -A INPUT -m conntrack --ctstate ESTABLISHED,RELATED -j ACCEPT |
8.7. ICMP 控制
Bash
1 | # 允许 ping(echo-request) |
运维建议:
生产服务器可根据安全要求决定是否放行 ping。很多安全规范要求对外网关闭 ICMP echo-request。
8.8. INPUT 防火墙(本机防护完整模板)
这是最常用的本机防火墙模板,建议直接使用:
Bash
1 | #!/bin/bash |
8.9. OUTPUT 防火墙(出站控制)
默认情况下 OUTPUT 策略是 ACCEPT,如需严格控制本机出站流量,可按以下思路:
Bash
1 | # 设置默认拒绝出站 |
注意:OUTPUT 默认 DROP 后,如果漏放 DNS 或软件源端口,会导致服务器无法解析域名或更新软件,请谨慎操作。
8.10. FORWARD 防火墙(转发控制)
当 Linux 作为网关、路由器或 Docker/K8s 节点时,需要控制转发流量。
1 | # 开启内核转发 |
Docker 环境特别注意:
Docker 会自动在 filter 和 nat 表插入大量规则。手动修改 FORWARD 链时,建议加在 Docker 规则之前,或使用 Docker 的 --iptables=false 选项自行完全接管。
实战口诀总结:
- 先放行已建立连接,再放行新建连接,最后再 DROP。
- SSH 规则永远优先写,防止把自己锁在外面。
- 能用网段就用网段,能用 ipset 就用 ipset。
- 修改规则后立刻 iptables-save 备份。
- 生产环境建议把完整规则写成脚本,方便审计和回滚。
把以上规则模板根据实际业务微调后,就能覆盖绝大多数日常防火墙需求。
9. iptables 与连接跟踪
连接跟踪(Connection Tracking,简称 conntrack)是 Netfilter 最核心的能力之一。
它让 iptables 从「无状态防火墙」变成「有状态防火墙」,同时也是 NAT 能够正确工作的基础。
没有 conntrack,就没有 -m state / -m conntrack,也没有可靠的 SNAT/DNAT。
9.1. conntrack 是什么
conntrack 是内核中的一个子系统(模块名 nf_conntrack),主要职责是:
- 跟踪每一条网络连接的完整生命周期
- 记录连接的五元组(源IP、源端口、目的IP、目的端口、协议)以及当前状态
- 为 iptables 的状态匹配和 NAT 提供数据支持
每一个被跟踪的连接都会在内核中生成一个 conntrack 条目,占用内存。
在高并发场景下,conntrack 表的大小直接关系到系统的稳定性和性能。
9.2. NEW
含义:一条连接的第一个包,表示「尝试建立新连接」。
- TCP:通常是带有 SYN 标志、尚未完成三次握手的包
- UDP / ICMP:第一个方向出现的包(因为它们本身是无连接的)
1 | # 只允许新的 SSH 连接 |
特点:
- 是访问控制的关键决策点
- 几乎所有「是否允许建立连接」的判断都应该放在 NEW 状态进行
9.3. ESTABLISHED
含义:连接已经成功建立,双方都已经有过数据交互。
- TCP:三次握手完成后的所有后续包
- UDP:已经观察到双向数据包之后的状态
1 | # 允许所有已建立的连接 |
特点:
- 一旦进入 ESTABLISHED,后续包都会自动匹配此状态
- 性能关键点:只需在 NEW 时做严格检查,后续包直接快速放行
9.4. RELATED
含义:与一条已经存在的连接「相关」的新连接。
典型场景:
- FTP 数据通道(主动模式 / 被动模式)
- ICMP 错误消息(目标不可达、超时等)
- 部分协议的辅助连接
1 | # 通常与 ESTABLISHED 一起放行 |
注意:
- 需要内核加载对应的辅助模块才能正确识别(如 nf_conntrack_ftp、nf_conntrack_tftp 等)
- 如果相关模块未加载,RELATED 状态可能无法正确匹配
9.5. INVALID
含义:无法被识别或状态非法的包。
常见情况包括:
- TCP 标志位组合错误
- 包属于一个已经超时或不存在的连接
- 序列号错误、状态机混乱等
1 | # 强烈建议直接丢弃 |
运维建议:
生产环境中几乎总是把 INVALID 直接 DROP,既能减少攻击面,也能避免无意义的包浪费 CPU 和内存。
9.6. –ctstate
--ctstate 是 conntrack 模块提供的匹配选项,用于匹配连接当前所处的状态。
推荐写法(现代系统优先使用):
1 | iptables -A INPUT -m conntrack --ctstate ESTABLISHED,RELATED -j ACCEPT |
旧式写法(兼容性更好,但已逐渐被替代):
1 | iptables -A INPUT -m state --state ESTABLISHED,RELATED -j ACCEPT |
两者功能基本一致。新系统建议优先使用 -m conntrack –ctstate。
支持同时匹配多个状态(逗号分隔):
Bash
1 | --ctstate NEW,ESTABLISHED |
9.7. 为什么通常要允许 ESTABLISHED,RELATED
这是有状态防火墙最重要的最佳实践之一:
Bash
1 | # 几乎所有生产规则的前两句 |
核心原因:
- 性能
新建连接(NEW)只做一次严格的匹配检查。
后续所有包直接命中 ESTABLISHED,规则匹配效率极高。 - 安全
只在 NEW 状态进行精细的访问控制(来源 IP、端口等)。
已经建立的连接默认信任,避免重复检查。 - 功能完整性
RELATED 能让 FTP、ICMP 错误消息等正常工作。 - 防止自己锁自己
通过 SSH 登录服务器后修改规则时,ESTABLISHED 能保证当前连接不会被意外切断。
标准推荐顺序:
1 | # 1. 丢弃非法包 |
9.8. 查看 conntrack
1. 查看当前连接数:
1 | conntrack -C |
2. 查看最大允许连接数:
1 | cat /proc/sys/net/netfilter/nf_conntrack_max |
3. 查看具体连接条目:
1 | # 查看所有连接(数量大时慎用) |
4. 删除连接条目(谨慎操作):
Bash
1 | # 删除与某个 IP 相关的所有连接 |
5. 调整 conntrack 表大小(高并发场景必备):
Bash
1 | # 临时生效 |
运维监控重点:
- 关注 nf_conntrack_count 是否接近 nf_conntrack_max
- 接近上限时会出现新连接无法建立的问题,dmesg 中通常会有 nf_conntrack: table full 日志
- 网关、负载均衡、NAT 设备必须根据实际并发量调大此值
最佳实践一句话:
- 先 DROP INVALID → 再放行 ESTABLISHED,RELATED → 然后精细控制 NEW → 最后默认拒绝。
把这个顺序固化到你的规则模板中,防火墙就会既安全又高效。
10. NAT 详解
NAT(Network Address Translation,网络地址转换)是 iptables 中最常用、也最容易出错的功能之一。
它通过修改数据包的源地址或目的地址,实现内网与公网的互通、端口映射、负载均衡等需求。
NAT 相关规则只能写在 nat 表,并且只能使用特定的链。
10.1. 什么是 NAT
NAT 的核心作用是:在数据包经过防火墙时,动态修改其源 IP 或目的 IP(有时也包括端口)。
根据修改的对象不同,主要分为两类:
| 类型 | 全称 | 修改对象 | 主要使用链 | 典型场景 |
|---|---|---|---|---|
| SNAT | Source NAT | 源地址 | POSTROUTING | 内网主机访问外网 |
| DNAT | Destination NAT | 目的地址 | PREROUTING、OUTPUT | 端口映射、对外发布服务 |
| MASQUERADE | 动态 SNAT | 源地址 | POSTROUTING | 出口 IP 不固定时的共享上网 |
重要前提:
- 内核必须开启 IP 转发(
ip_forward = 1)- NAT 只对新建连接的第一个包生效,后续包由 conntrack 自动完成转换
10.2. SNAT
含义:修改数据包的源地址,让内网主机以网关的公网 IP 身份访问外部网络。
只能使用在 nat 表的 POSTROUTING 链。
1 | # 将 192.168.1.0/24 网段的源地址转换为固定公网 IP 203.0.113.10 |
适用场景:
- 服务器拥有固定公网 IP
- 需要明确控制出口 IP 地址
实验验证:
1 | # 在内网主机上访问外网,同时在网关抓包 |
10.3. DNAT
含义:修改数据包的目的地址(和可选端口),实现端口映射或流量牵引。
主要使用在 nat 表的 PREROUTING 链(也可用于 OUTPUT)。
1 | # 将到达本机 80 端口的流量转发到内网 192.168.1.100:8080 |
关键注意:
- DNAT 发生在路由判断之前,所以改完目的地址后,内核会重新做路由决策
- 仅仅做 DNAT 通常还不够,还需要配合 FORWARD 链放行转发流量
10.4. MASQUERADE
含义:动态的 SNAT,自动使用出口网卡当前的 IP 地址作为源地址。
只能使用在 nat 表的 POSTROUTING 链。
1 | # 最经典的共享上网规则 |
SNAT vs MASQUERADE 对比:
| 对比项 | SNAT | MASQUERADE |
|---|---|---|
| 源地址 | 需要手动指定固定 IP | 自动获取出口网卡当前 IP |
| 适用场景 | 公网 IP 固定 | 公网 IP 动态变化(PPPoE、DHCP) |
| 性能 | 更高(无需每次查询接口 IP) | 稍低 |
| 推荐使用 | 固定 IP 时优先使用 | 动态 IP 时必须使用 |
运维建议:能用 SNAT 就用 SNAT,性能更好;只有出口 IP 会变时才使用 MASQUERADE。
10.5. 端口转发
端口转发是 DNAT 最常见的实战场景,完整规则通常需要三部分配合:
1 | # 1. 开启转发 |
实验验证:
1 | # 从外部访问网关公网 IP 的 80 端口 |
10.6. 一对一 NAT
一对一 NAT(也叫静态 NAT)是将一个内网 IP 固定映射到一个公网 IP,实现双向互通。
1 | # 内网 192.168.1.100 ↔ 公网 203.0.113.100 |
适用场景:
- 需要给内网服务器分配独立公网 IP
- 对延迟和会话保持要求较高的业务
10.7. 多公网 IP NAT
当服务器拥有多个公网 IP 时,可以根据需求做不同的地址转换。
1 | # 假设 eth0 有两个公网 IP:203.0.113.10 和 203.0.113.11 |
进阶玩法:结合 MARK + 策略路由,实现更精细的多出口控制。
10.8. NAT 与 conntrack 的关系
NAT 和 conntrack 是深度绑定的:
NAT 只处理连接的第一个包
后续包的地址转换完全由 conntrack 根据第一条记录自动完成。conntrack 记录了转换前后的映射关系
所以即使是双向流量,也能正确进行反向转换。查看 NAT 转换记录:
1
conntrack -L -n | grep 192.168.1
常见问题排查:
- NAT 规则写了但不生效 → 检查是否开启了 ip_forward
- 只有单向通 → 检查 FORWARD 链是否放行,以及是否缺少 ESTABLISHED 规则
- 连接数过高导致 NAT 异常 → 调大 nf_conntrack_max
经典完整 NAT 网关模板:
1 | # 开启转发 |
本节核心总结:
记住三句话:
- NAT 规则只能写在 nat 表。
- SNAT/MASQUERADE 在 POSTROUTING,DNAT 在 PREROUTING。
- NAT 依赖 conntrack,只处理连接的第一个包。
掌握这些后,端口转发、共享上网、一对一映射等问题都能轻松解决。
11. iptables 实现端口转发
端口转发是 NAT 最常见的实战场景之一。
很多同学只写一条 DNAT 规则就期望生效,结果发现「外部访问不通」或「内网自己访问公网端口也不通」,问题往往出在转发路径和回程路径上。
本节把端口转发相关的完整原理和坑点一次讲清楚。
11.1. DNAT
端口转发的核心是 DNAT(目的地址转换)。
它把到达网关公网 IP 某端口的流量,修改目的地址后转发到内网真实服务器。
1 | # 将到达本机 80 端口的流量转发到内网 192.168.1.100:8080 |
执行位置:nat 表的 PREROUTING 链(路由判断之前)。
效果:
- 外部客户端看到的是网关的公网 IP:80
- 实际处理请求的是内网 192.168.1.100:8080
11.2. SNAT
在端口转发场景中,SNAT 主要用于解决回程路径问题(见 11.5)。
当内网服务器响应外部请求时,如果源地址仍是内网 IP,回程包可能无法正确回到客户端。通过 SNAT 可以把响应包的源地址改成网关的公网 IP。
1 | # 对转发到内网的流量做 SNAT(可选,取决于网络拓扑) |
更常见的做法是直接对整个内网做 MASQUERADE:
1 | iptables -t nat -A POSTROUTING -s 192.168.1.0/24 -o eth0 -j MASQUERADE |
11.3. DNAT + FORWARD
完整的端口转发规则至少需要两部分:
- nat 表做 DNAT(修改目的地址)
- filter 表的 FORWARD 链放行转发
1 | # 1. 开启内核转发 |
实验验证:
Bash
1 | # 在网关上看 DNAT 是否生效 |
11.4. 只做 DNAT 为什么不够
很多初学者只写一条 DNAT 规则,然后发现外部无法访问,原因主要有两个:
原因一:没有开启 IP 转发
Bash
1 | # 必须开启 |
原因二:FORWARD 链默认策略是 DROP,或者没有放行规则
DNAT 只负责「改地址」,改完之后包还要经过 FORWARD 链。
如果 FORWARD 链没有允许这个包通过,内核会直接丢弃。
完整最小规则集:
Bash
1 | echo 1 > /proc/sys/net/ipv4/ip_forward |
11.5. 回程路径问题
端口转发不仅要解决「去程」,还要解决「回程」。
典型问题现象:
- 外部能看到连接建立,但数据传输中断
- 或者完全无法建立连接
原因分析:
- 外部客户端 → 网关(DNAT)→ 内网服务器
- 内网服务器响应时,源地址是内网 IP(192.168.1.100)
- 如果内网服务器的默认网关不是我们的这台网关,或者回程路由异常,响应包就会走错路径
解决方案:
方案一:让内网服务器把网关设置为我们的转发机器(最推荐)
方案二:在网关上对回程流量做 SNAT(强制响应包从本机出去)
1 | # 对发往内网目标端口的流量做 SNAT,把源地址改成网关自己的内网 IP |
这样内网服务器会认为请求来自网关,响应也会回到网关,再由网关转发给外部客户端。
11.6. hairpin NAT(NAT 环回 / NAT Loopback)
问题场景:
内网用户想通过「公网 IP + 端口」访问已经做了端口转发的内网服务,结果无法访问。
这就是经典的 hairpin NAT(也叫 NAT loopback)问题。
原因:
内网主机访问公网 IP 时,包到达网关后被 DNAT 到内网服务器,但响应包的源地址是内网 IP,内网客户端无法把这个响应与自己发出的「公网 IP」请求对应起来。
解决方法:
需要额外再加一条 SNAT 规则,让内网访问公网端口的流量在转发时也被伪装:
1 | # 已有的 DNAT |
或者更通用的写法(对所有内网访问本机公网端口的流量做伪装):
1 | iptables -t nat -A POSTROUTING -s 192.168.1.0/24 -o eth0 -j MASQUERADE |
完整 hairpin 友好规则示例:
1 | # 开启转发 |
端口转发完整检查清单:
- ip_forward 是否开启?
- DNAT 规则是否正确写在 PREROUTING?
- FORWARD 链是否放行了目标地址和端口?
- 是否放行了 ESTABLISHED,RELATED?
- 回程路径是否正常?(网关设置或 SNAT)
- 内网用户是否需要通过公网 IP 访问?(需要 hairpin 规则)
把以上六点都覆盖到,端口转发基本就能稳定工作。
12. Linux 路由与 iptables
iptables 负责「包的过滤与地址转换」,而 Linux 路由子系统负责「包该从哪块网卡、哪条路径出去」。
两者紧密配合,尤其在多网卡、多出口、策略路由场景中,几乎总是一起出现。
理解它们的协作关系,是实现复杂网络策略的基础。
12.1. iptables 与路由的关系
简单总结两者的分工:
| 组件 | 主要职责 | 关键位置 |
|---|---|---|
| iptables | 过滤、修改、标记数据包 | Netfilter Hook |
| 路由子系统 | 决定数据包的下一跳和出口网卡 | 路由查找(Route Lookup) |
协作流程(以进入本机的包为例):
- 包进入网卡 → PREROUTING(iptables 可在此做 DNAT、MARK)
- 路由判断(Route Lookup):决定是交给本机还是转发
- 如果是转发 → FORWARD → 再次路由判断 → POSTROUTING
- 如果是本机发出 → OUTPUT → 路由判断 → POSTROUTING
iptables 可以通过 MARK 给包打标记,然后路由子系统根据标记选择不同的路由表,这就是策略路由的核心。
12.2. route lookup 发生在哪里
Linux 网络栈中,路由查找主要发生在两个关键点:
PREROUTING 之后
决定包是进入本机(INPUT)还是转发(FORWARD)。OUTPUT / FORWARD 之后、POSTROUTING 之前
决定包最终从哪块网卡、哪个下一跳出去。
对应关系如下:
数据包进入 → PREROUTING(iptables:DNAT、MARK) → 路由判断 ①(决定 INPUT 还是 FORWARD) → INPUT 或 FORWARD → 路由判断 ②(决定出口网卡和下一跳) → POSTROUTING(iptables:SNAT、MASQUERADE) → 从网卡发出
重点:
- 在 PREROUTING 中做的 MARK,可以影响第一次路由判断;
- 在 OUTPUT 或 PREROUTING 中做的 MARK,也可以影响最终的出口选择。
12.3. ip rule
ip rule 用于管理策略路由规则,它决定「根据什么条件,去哪张路由表查询」。
查看当前策略规则:
1 | ip rule show |
默认规则通常是:
1 | 0: from all lookup local |
常用操作:
1 | # 添加规则:来自 192.168.1.0/24 的包,使用路由表 100 |
优先级:数字越小,优先级越高。
12.4. ip route
ip route 用于管理路由表中的具体路由条目。
Linux 支持多张路由表,常用的有:
- local(表 255):本地路由
- main(表 254):主路由表(默认)
- default(表 253):默认路由表
- 自定义表(如 100、200)
常用操作:
1 | # 查看主路由表 |
查看所有路由表:
1 | ip route show table all |
12.5. fwmark
fwmark(firewall mark)是一个保存在数据包中的标记值,由 iptables 的 MARK 目标设置,供路由子系统或其他工具(如 tc)使用。
1 | # 给匹配的包打上标记 100 |
常用 MARK 相关动作:
| 动作 | 含义 |
|---|---|
| --set-mark 100 | 直接设置标记为 100 |
| --and-mark 0xff | 按位与 |
| --or-mark 0x100 | 按位或 |
| --xor-mark 0x1 | 按位异或 |
| --set-xmark 100/0xffffffff | 更灵活的设置方式 |
标记值是一个 32 位整数,常用较小的数字(如 1、100、200)便于管理。
12.6. MARK + policy routing
这是实现策略路由最经典的组合,流程如下:
- 用 iptables 给特定流量打上 fwmark
- 用 ip rule 根据 fwmark 选择不同的路由表
- 在对应的路由表中设置不同的出口网关
完整示例:让内网不同网段走不同出口
假设:
- eth0:出口 1,网关 203.0.113.1
- eth1:出口 2,网关 198.51.100.1
- 希望 192.168.1.0/24 走出口 1,192.168.2.0/24 走出口 2
1 | # 1. 给不同网段打标记 |
验证方法:
1 | # 查看策略规则 |
12.7. 多出口 IP
当服务器拥有多个公网 IP(多归属)时,常需要控制「不同流量使用不同出口 IP」。
场景一:不同内网网段使用不同公网 IP 出去
Bash
1 | # 使用 SNAT 直接指定出口 IP(简单场景) |
场景二:结合策略路由实现更灵活的控制
1 | # 1. 打标记 |
场景三:本机进程使用不同出口 IP
对本机发出的流量,需要在 OUTPUT 链打标记:
1 | # 本机访问特定目标时使用指定出口 |
实战检查清单:
- 标记是否在正确的链(PREROUTING 或 OUTPUT)打上?
- ip rule 优先级是否合理?
- 自定义路由表是否有默认路由?
- 是否需要配合 SNAT 保证源 IP 正确?
- 修改后是否执行了 ip route flush cache?
掌握这些内容后,多网卡负载分担、主备出口、基于来源的选路等需求都能从容应对。
13. UDP 与 iptables
UDP 是无连接协议,但在 iptables 和 conntrack 的世界里,它被「模拟」成了有状态的连接。
正是这种模拟,导致 UDP 在 NAT、多公网 IP、策略路由等场景下比 TCP 更容易出问题。
理解 UDP 与 TCP 在连接跟踪上的差异,是排查 DNS、VPN、游戏、语音等 UDP 业务故障的关键。
13.1. UDP 与 TCP 的区别
| 对比项 | TCP | UDP |
|---|---|---|
| 连接导向 | 有(三次握手、四次挥手) | 无 |
| 状态机 | 复杂(SYN、ESTABLISHED、FIN 等) | 简单(只有「看到双向包」) |
| conntrack 超时 | 较长(建立后通常数小时) | 较短(默认 30 秒或 180 秒) |
| 回程包识别 | 依靠序列号 + 状态机 | 仅依靠五元组 |
| NAT 友好性 | 较高 | 较低,容易出问题 |
| 策略路由影响 | 相对稳定 | 更容易受源地址选择影响 |
核心差异:
- TCP 有明确的连接建立和拆除过程,conntrack 能精准跟踪;
- UDP 没有连接概念,conntrack 只能通过「在超时时间内看到反向数据包」来判断一条「伪连接」是否还活着。
13.2. UDP conntrack
虽然 UDP 无连接,但 Netfilter 仍然会为它创建 conntrack 条目。
UDP 连接跟踪的典型生命周期:
- 第一个包到达 → 创建条目,状态为 NEW
- 看到反向包 → 状态变为 ESTABLISHED
- 在超时时间内一直有双向包 → 保持 ESTABLISHED
- 超时无包 → 条目删除
默认超时时间(可调整):
1 | # 查看 UDP 超时 |
调整示例:
1 | # 临时修改 |
查看 UDP 连接:
1 | conntrack -L -p udp |
13.3. UDP NAT
UDP 的 NAT 与 TCP 基本相同,但因为没有连接状态机,更容易出现回程问题。
典型 DNAT 示例(DNS 转发):
1 | # 把到达本机 53 端口的 UDP 流量转发到内网 DNS 服务器 |
SNAT / MASQUERADE 示例:
1 | iptables -t nat -A POSTROUTING -s 192.168.1.0/24 -p udp -o eth0 -j MASQUERADE |
注意:
- UDP NAT 后,conntrack 会记录「原始五元组 ↔ 转换后五元组」的映射。
- 只要反向包能在超时时间内回来,并且五元组匹配,就能正确还原。
13.4. UDP 回包为什么容易出问题
UDP 回包出问题是生产中最常见的故障之一,主要原因有:
- 超时过短
默认 30 秒,如果业务心跳间隔较长,条目提前删除,回包就无法匹配。 - 源端口变化
某些应用每次发送都使用新的源端口,导致 conntrack 认为是全新连接。 - 多网卡 / 多公网 IP 下源地址选择错误
回包的源 IP 与去程 NAT 后的地址不一致,客户端无法识别。 - 策略路由导致回程路径不一致
去程和回程走了不同的出口,NAT 映射无法正确命中。 - 助手模块缺失
虽然 UDP 本身不需要助手,但某些应用层协议(如 SIP、FTP 的 UDP 模式)需要额外模块。
排查思路:
1 | # 1. 看 conntrack 是否有对应条目 |
13.5. 多公网 IP 下的 UDP 源地址
当服务器有多个公网 IP 时,UDP 的源地址选择比 TCP 更敏感。
问题现象:
去程用了 IP-A,回程却用了 IP-B,导致对端无法匹配会话。
解决方法一:使用 SNAT 强制指定源 IP
1 | # 强制某类 UDP 流量使用指定公网 IP 出去 |
解决方法二:结合 MARK + 策略路由 + SNAT
1 | # 1. 打标记 |
13.6. source in / source out
在多网卡或多 IP 场景下,常需要区分「流量从哪个地址进来」和「从哪个地址出去」。
常用匹配方式:
1 | # 匹配从指定网卡进入的 UDP 包 |
结合 conntrack 查看实际使用的地址:
1 | conntrack -L -p udp -s 203.0.113.10 |
在做 UDP 相关的 NAT 或策略路由时,明确「source in」和「source out」能大幅减少排查时间。
13.7. UDP 与策略路由
策略路由对 UDP 的影响比 TCP 更大,因为 UDP 没有序列号和严格的状态机来「纠正」路径不一致。
典型问题:
去程通过策略路由走了出口 A,回程因为路由表优先级问题走了出口 B,导致 NAT 映射失效或对端收到错误源地址的包。
推荐做法:
- 对去程和回程使用对称的标记与路由规则
- 尽量用 SNAT 固定源地址,减少路由选择的不确定性
- 对 UDP 超时时间适当调大,给回程包更多容忍时间
完整示例:让特定 UDP 业务走指定出口
1 | # 1. 给目标端口打标记 |
排查 UDP 问题的常用命令组合:
1 | # 看连接跟踪 |
把这些点掌握后,UDP 相关的防火墙和 NAT 问题就能快速定位并解决。
14. iptables 高级功能
基础的匹配条件(源/目的 IP、端口、协议)已经能解决大部分问题,但在面对大量 IP 黑白名单、暴力破解防护、频率限制、复杂流量识别等场景时,就需要用到 iptables 的扩展模块。
这些模块通过 -m 加载,能显著提升规则的灵活性和性能。
14.1. ipset
作用:高效管理大量 IP、网段、端口集合,避免写数百条规则。
为什么需要它:
直接用 -s 写 1000 个 IP,规则匹配性能会明显下降;ipset 使用哈希表,匹配速度几乎与集合大小无关。
常用操作:
1 | # 安装(如未安装) |
运维价值:
黑名单、白名单、地理 IP 库、动态封禁等场景的首选方案。支持动态添加/删除,无需重载 iptables 规则。
14.2. recent
作用:根据「最近一段时间内某 IP 的连接次数」做动态决策,常用于防暴力破解。
1 | # 允许 SSH,但限制 60 秒内最多尝试 3 次 |
常用参数:
- --name:集合名称
- --set:把当前 IP 加入集合
- --update:更新命中时间
- --seconds:时间窗口
- --hitcount:命中次数阈值
- --rcheck:只检查不更新
查看当前记录:
1 | cat /proc/net/xt_recent/SSH |
14.3. limit
作用:简单的速率限制,控制单位时间内匹配的包数量。
1 | # 限制 ping 频率:平均每秒 1 个,突发允许 5 个 |
参数说明:
- --limit 1/s、5/m、10/h:平均速率
- --limit-burst:突发允许的数量
缺点:所有匹配的包共享同一个令牌桶,无法针对单个 IP 做限制(这是 hashlimit 的强项)。
14.4. hashlimit
作用:比 limit 更强大的限速,可按 IP、端口等维度分别限制。
1 | # 每个源 IP 每分钟最多新建 10 个 SSH 连接 |
常用参数:
- --hashlimit-name:名称(对应 /proc/net/ipt_hashlimit/ 下的文件)
- --hashlimit-mode srcip / dstip / srcip-dstip 等
- --hashlimit-above:超过此速率就匹配
- --hashlimit-burst:突发量
运维场景:防暴力破解、防 CC 攻击、限制单 IP 连接频率的首选。
14.5. connlimit
作用:限制每个客户端 IP 的并发连接数。
Bash
1 | # 每个 IP 对 80 端口最多 20 个并发连接 |
参数:
- --connlimit-above n:超过 n 个连接就匹配
- --connlimit-mask:掩码(32 表示单个 IP,24 表示整个 C 段)
适用场景:防止单个 IP 占用过多连接(如爬虫、慢速攻击)。
14.6. string
作用:在数据包的应用层载荷中匹配字符串(需要内核支持)。
1 | # 丢弃包含特定恶意字符串的包 |
参数:
- --string:要匹配的字符串
- --hex-string:十六进制形式
- --algo bm / kmp:匹配算法(bm 通常更快)
注意:
性能开销较大,且只能匹配未加密的明文流量。不推荐在高流量生产环境大规模使用。
14.7. u32
作用:对数据包任意位置的 32 位数据进行精细匹配(高级玩法)。
1 | # 示例:匹配 IP 头部某个字段(较少日常使用) |
特点:功能极其强大,但语法复杂,可读性差。
通常只在需要深度包检测且不想上专业 IPS 设备时使用。
14.8. owner
作用:根据发送进程的用户 / 组 / PID 来匹配本机发出的包(仅对 OUTPUT 链有效)。
1 | # 只允许 uid 为 1000 的用户访问外网 |
适用场景:
- 多用户服务器上限制特定用户的出站权限
- 容器或特定服务的流量隔离
14.9. mark
作用:匹配或设置数据包的 fwmark(防火墙标记)。
1 | # 设置标记(在 mangle 表) |
与策略路由配合是它最重要的用途(见第 12 节)。
14.10. connmark
作用:对整个连接进行标记,而不是单个包。标记会保存在 conntrack 条目中,同一连接的所有后续包都能继承。
1 | # 给连接打标记 |
经典组合模板(先恢复,再按需设置并保存):
Bash
1 | iptables -t mangle -A PREROUTING -j CONNMARK --restore-mark |
MARK vs CONNMARK:
| 对比项 | MARK | CONNMARK |
|---|---|---|
| 作用对象 | 单个数据包 | 整个连接 |
| 生命周期 | 只影响当前包 | 连接跟踪期间有效 |
| 典型用途 | 临时分类、流量控制 | 需要连接级一致性标记 |
实战建议:
- 能用 ipset 解决的绝不用大量 -s 规则。
- 防暴力破解优先用 hashlimit 或 recent + connlimit 组合。
- 标记相关操作统一放在 mangle 表。
- 所有频率限制规则都要考虑「先记录日志再拒绝」,方便后续分析。
这些高级功能组合使用后,iptables 就能应对绝大多数复杂的安全和流量控制需求。
15. 自定义 Chain
当规则数量越来越多时,把所有规则都塞在 INPUT、FORWARD、OUTPUT 这几条内置链里,会变得难以维护和阅读。
自定义 Chain(用户自定义链)就是为了解决这个问题而生的。
15.1. 为什么需要自定义 Chain
使用自定义链的主要好处:
结构清晰
把不同类型的规则分组(如 SSH 防护、Web 服务、内网访问、日志记录等),便于理解和审计。复用规则
同一段规则逻辑可以在多处通过跳转复用,避免重复编写。提升性能
通过早期跳转,让不相关的包尽早离开当前检查路径,减少后续无效匹配。便于维护
修改某一类规则时,只需关注对应的自定义链,而不用在成百上千条规则中查找。更好的权限与责任分离
不同管理员或自动化系统可以只管理自己的链。
15.2. 创建 Chain
使用 -N(new)创建一条新的自定义链:
1 | # 创建自定义链 |
注意事项:
- 自定义链的名称区分大小写
- 名称建议使用大写 + 下划线,便于与内置链区分
- 创建后链是空的,需要手动添加规则
15.3. 跳转到 Chain
使用 -j 跳转到自定义链,效果类似于函数调用:
1 | # 在 INPUT 链中,把 SSH 相关流量跳转到 SSH_CHAIN |
跳转后的行为:
- 包进入自定义链后,从该链的第一条规则开始匹配
- 如果匹配到 ACCEPT、DROP、REJECT 等终止动作,则立即结束整个检查
- 如果匹配到 RETURN,则返回到调用它的链,继续执行下一条规则
- 如果自定义链所有规则都匹配完毕仍未终止,也会自动返回
15.4. RETURN
RETURN 是自定义链中非常重要的动作,表示「返回到调用链继续处理」。
1 | iptables -N MY_CHAIN |
对比:
- 在自定义链末尾写 RETURN:明确返回
- 不写任何终止动作:链结束后也会自动返回(隐式 RETURN)
- 在内置链(INPUT 等)中使用 RETURN:效果等同于该链的默认策略
15.5. 删除 Chain
删除自定义链有严格的前提条件:
- 链必须为空(没有规则)
- 没有被其他链引用(没有 -j 跳转到它)
正确删除步骤:
1 | # 1. 先删除所有跳转到该链的规则 |
常用清理命令:
1 | # 清空所有自定义链中的规则 |
注意:-X 只能删除自定义链,无法删除内置链(INPUT、FORWARD、OUTPUT 等)。
15.6. 组织大型规则集
生产环境中推荐的规则组织方式:
1. 按功能划分链
1 | iptables -N SSH_PROTECT |
2. 在内置链中只做「分类跳转」
1 | # INPUT 链保持简洁 |
3. 在自定义链中写具体逻辑
1 | # SSH 防护链 |
4. 推荐的整体结构模板
1 | INPUT |
运维建议:
- 自定义链名称要有意义,见名知意
- 保持内置链规则数量尽量少(只做分类)
- 每条自定义链职责单一
- 修改规则前先 iptables-save > backup.rules
- 大型规则集建议写成脚本,并用版本管理(git)跟踪变更
最佳实践一句话:
- 内置链负责分类跳转,自定义链负责具体逻辑。
用好自定义链,规则集从「难以维护的流水账」变成「结构清晰的模块化代码」,是 iptables 进阶的重要标志。
16. 日志与排障
iptables 规则写完后不生效、包被莫名丢弃、NAT 转换异常……这些是运维中最常见的问题。
掌握系统化的排查方法,比反复试规则高效得多。
16.1. LOG target
LOG 是排障时最直接的工具,它能把匹配到的数据包信息写入内核日志,并且不会终止规则匹配。
1 | # 基础用法 |
常用参数:
- --log-prefix “前缀”:自定义前缀,方便过滤(建议以空格结尾)
- --log-level 4:日志级别(0-7,4 为 warning)
- --log-tcp-sequence:记录序列号
- --log-tcp-options:记录 TCP 选项
- --log-ip-options:记录 IP 选项
- --log-uid:记录发送进程的 UID(OUTPUT 链有用)
注意:LOG 规则一定要放在 DROP/REJECT 之前,否则包已经被丢弃就无法记录。
16.2. 查看内核日志
LOG 目标写入的是内核日志,查看方式因发行版而异:
1 | # CentOS / RHEL / Fedora |
实时监控推荐:
1 | # 持续观察内核日志 |
16.3. iptables counters
每条规则都有包计数器和字节计数器,是判断规则是否命中的最快方法。
1 | # 查看规则及计数器 |
排障技巧:
- 先 iptables -Z 清零
- 发起测试流量
- 立刻查看 iptables -L -n -v,看哪条规则的计数器增加了
如果目标规则计数器不动,说明包根本没匹配到它(可能被前面的规则拦截,或条件写错)。
16.4. tcpdump
当日志和计数器都无法定位时,用 tcpdump 直接看数据包是最可靠的手段。
Bash
1 | # 抓取特定端口 |
结合 iptables 的排障流程:
- 在可疑位置加 LOG 规则
- 用 tcpdump 确认包是否到达网卡
- 对比 LOG 和 tcpdump 结果,判断包在哪一环消失
16.5. conntrack
查看连接跟踪表,能帮助判断 NAT 是否生效、连接状态是否正确、是否因为表满导致新连接失败。
Bash
1 | # 当前连接数 |
常见问题线索:
- nf_conntrack: table full → 连接数打满,需要调大 nf_conntrack_max
- 有去程条目但没有回程 → 回程路径或 SNAT 有问题
- 状态一直是 NEW 却不转 ESTABLISHED → 回包没有回来或被丢弃
16.6. ss
ss 是查看本机 socket 状态的现代工具,比 netstat 更快更详细。
1 | # 查看所有 TCP 连接 |
排障价值:
确认服务是否真的在监听、连接是否建立成功、连接卡在哪个状态(SYN-SENT、ESTABLISHED、TIME-WAIT 等)。
16.7. ip route
路由问题常被误判为 iptables 问题,尤其是在多网卡、策略路由场景。
Bash
1 | # 查看主路由表 |
重点检查:
- 默认路由是否正确
- 自定义路由表是否有默认路由
- ip route get 的结果是否符合预期
16.8. ip rule
策略路由规则决定了「用哪张路由表」,优先级错误会导致流量走错出口。
Bash
1 | # 查看所有策略规则 |
排障要点:
- 规则优先级是否符合预期(数字越小优先级越高)
- 是否有 catch-all 规则把流量提前拦截
- 对应的 table 是否真的存在有效路由
16.9. 排查 DROP
包被 DROP 是最常见的故障,推荐按以下顺序排查:
标准排查流程:
清零计数器并复现
Bash
1
2
3iptables -Z
# 发起测试流量
iptables -L -n -v --line-numbers在可能 DROP 的位置前加 LOG
Bash
1
iptables -I INPUT -j LOG --log-prefix "INPUT_CHECK: "
检查默认策略
Bash
1
iptables -L -n | grep policy
检查是否有靠前的 DROP/REJECT 规则 规则是从上到下匹配的,前面的规则会优先生效。
确认包是否到达主机
Bash
1
tcpdump -i any host 客户端IP -nn
检查 conntrack 状态 是否被 INVALID 规则提前丢弃。
16.10. 排查 NAT
NAT 不生效或单向通,是另一个高频问题。
完整检查清单:
确认 ip_forward 已开启
Bash
1
2cat /proc/sys/net/ipv4/ip_forward
# 必须为 1检查 nat 表规则和计数器
Bash
1
iptables -t nat -L -n -v --line-numbers
检查 FORWARD 链是否放行
Bash
1
iptables -L FORWARD -n -v
查看 conntrack 中的 NAT 映射
Bash
1
conntrack -L -n | grep 内网IP或端口
抓包对比去程和回程
Bash
1
2
3
4
# 在网关公网网卡
tcpdump -i eth0 port 80 -nn
# 在内网网卡或目标服务器
tcpdump -i eth1 port 8080 -nn检查回程路径
- 内网服务器网关是否指向正确
- 是否需要额外的 SNAT/hairpin 规则
检查策略路由是否干扰
Bash
1
2ip rule show
ip route get 目标IP from 源IP
常见 NAT 故障速查:
| 现象 | 可能原因 | 检查方向 |
|---|---|---|
| 完全不通 | 没开转发 / DNAT 规则错误 / FORWARD 丢弃 | ip_forward、nat 表、FORWARD |
| 单向通(只有去程) | 回程路径错误 / 缺少 SNAT | 内网网关、POSTROUTING |
| 内网无法通过公网 IP 访问 | hairpin NAT 问题 | 额外 SNAT 规则 |
| 连接数多了就失败 | conntrack 表满 | nf_conntrack_max |
| 偶发失败 | UDP 超时过短 / 策略路由不对称 | conntrack 超时、ip rule |
本节排障工具速查:
| 工具 | 主要用途 | 关键命令示例 |
|---|---|---|
| LOG target | 记录匹配到的包 | -j LOG –log-prefix “XXX: “ |
| 计数器 | 判断规则是否命中 | iptables -L -n -v |
| tcpdump | 确认包是否到达及内容 | tcpdump -i any port 22 -nn |
| conntrack | 查看连接状态与 NAT 映射 | conntrack -L -n |
| ss | 查看本机 socket 状态 | ss -tlnp |
| ip route | 检查路由决策 | ip route get 8.8.8.8 |
| ip rule | 检查策略路由 | ip rule show |
排障总原则:
先看计数器 → 再看日志 → 然后抓包 → 最后查路由和 conntrack。
按照这个顺序,绝大多数 iptables 问题都能快速定位。
17. 常见故障案例
理论讲得再多,不如真实故障来得深刻。
以下是生产环境中出现频率最高、也最容易让人踩坑的 iptables 故障案例,每个案例都给出现象、原因、排查方法和解决方案。
17.1. SSH 被锁死
现象:
执行完 iptables 规则后,SSH 连接立刻断开,并且无法重新连上服务器。
常见原因:
- 设置了
INPUT默认策略为DROP,但忘记放行 SSH 端口 - 放行 SSH 的规则写在了 DROP 规则后面
- 只放行了 NEW,但当前连接变成了 INVALID 或没有 ESTABLISHED 规则
- 源地址限制写错,把自己的 IP 排除在外
排查与恢复(需通过控制台 / VNC / IPMI):
1 | # 立即放行 SSH(临时救命) |
正确写法(推荐模板):
Bash
1 | # 1. 先放行已建立连接(防止自己被踢) |
预防措施:
- 修改规则前先开一个不会断开的备用会话
- 使用 iptables-apply 或自己写带超时回滚的脚本
- 云服务器尽量保留控制台访问手段
17.2. DNAT 后无法访问
现象:
写了 DNAT 规则,外部访问公网 IP 对应端口完全不通。
常见原因:
- 没有开启 ip_forward
- FORWARD 链默认 DROP,且没有放行规则
- DNAT 规则写错链或表(必须写在 nat 表的 PREROUTING)
- 目标内网机器防火墙拦截了流量
排查步骤:
Bash
1 | # 1. 确认转发已开启 |
完整正确规则:
Bash
1 | echo 1 > /proc/sys/net/ipv4/ip_forward |
17.3. NAT 后没有回包
现象:
去程流量正常(能看到 DNAT 或 SNAT 命中),但响应包回不来,表现为连接超时或单向通信。
常见原因:
- 内网服务器的默认网关不是当前这台 NAT 机器
- 回程包没有做正确的 SNAT,源地址仍是内网 IP
- 策略路由导致回程走了不同出口
- 目标机器开启了反向路径过滤(rp_filter)
排查方法:
Bash
1 | # 查看 conntrack 是否有完整双向记录 |
解决方案:
让内网服务器指向正确的网关(推荐)
或在网关上对回程做 SNAT:
Bash
1
iptables -t nat -A POSTROUTING -d 192.168.1.100 -j SNAT --to-source 网关内网IP
检查并关闭严格反向路径过滤(如有需要):
Bash
1
2echo 0 > /proc/sys/net/ipv4/conf/all/rp_filter
echo 0 > /proc/sys/net/ipv4/conf/eth0/rp_filter
17.4. UDP 转发异常
现象:
TCP 端口转发正常,但 UDP(DNS、VPN、游戏、语音等)不通或时通时断。
常见原因:
- UDP conntrack 超时过短(默认 30 秒)
- 多公网 IP 下源地址选择不一致
- 策略路由导致去程和回程路径不对称
- 没有放行 ESTABLISHED 状态的 UDP 回包
解决方法:
Bash
1 | # 1. 适当增大 UDP 超时 |
17.5. 多公网 IP 出口错误
现象:
服务器有多个公网 IP,访问外网时源 IP 不符合预期,或回包到达错误的 IP 导致通信失败。
常见原因:
- 没有用 SNAT 强制指定源地址,系统按路由自由选择
- 策略路由规则优先级或标记错误
- 本机发出的流量(OUTPUT)没有打标记
解决方法:
Bash
1 | # 方法一:简单粗暴用 SNAT 固定 |
17.6. Docker 修改 iptables
现象:
重启 Docker 或容器后,自己写的 iptables 规则被覆盖、顺序被打乱,或 FORWARD 链出现大量 Docker 规则导致转发异常。
原因:
Docker 默认会操作 iptables(filter 和 nat 表),并在启动时重新插入自己的规则。
解决方案:
方案一:让 Docker 不再管理 iptables(推荐生产)
Bash
1 | # /etc/docker/daemon.json |
然后重启 Docker,自己完全接管规则。
方案二:把自定义规则加在 Docker 规则之前
Bash
1 | iptables -I FORWARD -s 192.168.1.0/24 -j ACCEPT |
方案三:使用 Docker 的 --iptables=false 启动参数
排查命令:
Bash
1 | iptables -L -n -v | grep -i docker |
17.7. firewalld 与 iptables 冲突
现象:
规则写了不生效,或重启后规则消失,系统同时运行了 firewalld 和 iptables。
原因:
CentOS 7/8、RHEL、Fedora 等系统默认使用 firewalld,它会动态管理 iptables/nftables 规则,与手动 iptables 命令冲突。
解决方法:
Bash
1 | # 1. 停止并禁用 firewalld |
检查是否冲突:
Bash
1 | systemctl status firewalld |
17.8. iptables 规则重启后消失
现象:
规则在当前生效,但服务器重启后全部丢失,恢复成空规则或默认策略。
原因:
iptables 规则默认只存在于内存中,重启后不会自动加载,必须手动保存并设置开机加载。
解决方法:
CentOS / RHEL:
Bash
1 | # 安装服务 |
Ubuntu / Debian:
Bash
1 | # 安装持久化工具 |
通用方法:
Bash
1 | # 备份 |
预防建议:
- 每次重要变更后立刻备份
- 把规则写成脚本,放入 /etc/rc.local 或 systemd service
- 使用 Ansible / Salt 等配置管理工具强制收敛
本节故障速查表:
| 故障 | 首要检查点 | 关键命令 / 操作 |
|---|---|---|
| SSH 被锁死 | 是否放行 22 + ESTABLISHED | 控制台执行 -I INPUT -p tcp –dport 22 -j ACCEPT |
| DNAT 不通 | ip_forward + FORWARD 链 | cat /proc/sys/net/ipv4/ip_forward |
| NAT 无回包 | 回程路径 / SNAT / rp_filter | conntrack -L -n + 抓包 |
| UDP 异常 | UDP 超时 + 源地址一致性 | 调大 nf_conntrack_udp_timeout |
| 多 IP 出口错误 | 是否强制 SNAT / 策略路由 | ip route get + SNAT 规则 |
| Docker 干扰 | Docker 是否管理 iptables | daemon.json 中 “iptables”: false |
| firewalld 冲突 | firewalld 是否在运行 | systemctl stop firewalld |
| 重启丢规则 | 是否保存并设置开机加载 | iptables-save + enable 服务 |
排障总原则:
先恢复业务(临时放行)→ 再保留现场(计数器、日志、conntrack)→ 最后系统分析原因并固化修复。
把这些案例记熟,遇到问题时就能快速对号入座,少走大量弯路。
18. iptables 与 firewalld
在 CentOS 7/8、RHEL、Fedora 等系统上,很多同学一边用 iptables 命令,一边又看到系统里跑着 firewalld,经常分不清谁才是真正在生效的规则。
本节把两者的关系、底层实现和常见困惑一次说清楚。
18.1. firewalld 是什么
firewalld 是 Red Hat 系发行版默认的动态防火墙管理工具。
它的主要特点:
- 支持动态更新规则,不需要重启整个防火墙
- 引入了 Zone(区域) 的概念,按网络信任级别管理规则
- 提供 D-Bus 接口,方便图形工具和其它程序调用
- 底层可以对接不同的包过滤后端(iptables 或 nftables)
常用命令示例:
1 | # 查看状态 |
18.2. firewalld 与 iptables 的关系
两者不是完全对立的关系,而是管理层与执行层的关系:
| 层级 | 工具 | 职责 |
|---|---|---|
| 用户/管理层 | firewalld | 提供更友好的接口、区域、动态规则管理 |
| 执行层 | iptables / nftables | 真正在内核中生效的规则 |
简单理解:
- 你用 firewall-cmd 添加的规则,最终还是会被转换成底层的 iptables 或 nftables 规则。
- 直接用 iptables 命令写的规则,firewalld 不一定知道,重启或 reload 后可能被覆盖。
冲突的典型表现:
- 手动 iptables -A 写的规则,执行 firewall-cmd –reload 后消失
- 两边规则同时存在,优先级混乱,导致行为不符合预期
官方建议:
- 如果使用 firewalld,就尽量只用 firewall-cmd 管理,不要混用 iptables 命令
- 如果坚持使用传统 iptables,就停用 firewalld
18.3. firewalld backend
firewalld 本身不直接操作内核,它通过 backend 把规则交给底层框架执行。
目前主要有两种后端:
- iptables 后端(旧)
- nftables 后端(新,默认)
查看当前使用的后端:
Bash
1 | firewall-cmd --get-backend |
常见配置文件位置:/etc/firewalld/firewalld.conf
Bash
1 | # 旧方式(使用 iptables) |
切换后端后需要重启 firewalld:
Bash
1 | systemctl restart firewalld |
18.4. iptables-nft
从 RHEL 8 / CentOS 8 开始,系统默认的 iptables 命令其实是 iptables-nft。
它是一个兼容层:
- 用户依然可以使用熟悉的 iptables 语法
- 底层实际调用的是 nftables
- 规则最终存在于 nftables 框架中,而不是传统的 xtables
查看当前 iptables 的实现:
Bash
1 | iptables -V |
切换方式(以 CentOS/RHEL 为例):
Bash
1 | # 切换到 legacy |
18.5. 为什么看到 iptables 规则但实际使用 nftables
这是现代系统中最容易让人困惑的一点。
原因解释:
- 系统默认安装的是 iptables-nft(命令叫 iptables,后端是 nftables)
- 你执行 iptables -L 时,看到的是兼容层翻译出来的“伪 iptables 规则”
- 真正在内核中生效的是 nftables 规则
- firewalld 默认也使用 nftables 后端
如何确认真实后端:
Bash
1 | # 1. 查看 iptables 版本信息 |
对比:
| 命令 | 实际查看的内容 |
|---|---|
| iptables -L | 兼容层翻译后的规则(可能不完整) |
| nft list ruleset | 真正在内核中生效的 nftables 规则 |
| iptables-legacy -L | 传统 xtables 规则(如果还在用) |
实战建议:
- 新系统(CentOS 8+ / Fedora 等):
优先学习并使用 nftables 或继续用 firewalld,不要强行回到 legacy iptables。 - 必须使用 iptables 语法时:
明确自己用的是 iptables-nft 还是 iptables-legacy,避免混用。 - 排查规则是否生效:
不要只看 iptables -L,一定要结合 nft list ruleset 和实际流量测试。 - 与 firewalld 共存时:
- 要么完全交给 firewalld 管理
- 要么停用 firewalld,自己用 iptables/nftables 管理
- 不要两边同时写规则
一句话建议:
在现代 Linux 发行版上,把 iptables 当作“兼容命令”来看待,真正理解底层是 nftables 还是 legacy,才能避免“规则写了却不生效”的困惑。
19. iptables 与 nftables
从 RHEL 8 / CentOS 8 / Debian 10 / Ubuntu 20.04 开始,Linux 发行版逐渐把默认的包过滤框架从传统的 iptables(xtables)转向了 nftables。
理解两者的关系和迁移方式,是现代 Linux 网络管理的必修课。
19.1. 为什么 Linux 转向 nftables
传统 iptables(xtables)存在几个长期痛点:
多表多链架构复杂
filter、nat、mangle、raw、security 五张表,规则分散,管理成本高。性能瓶颈
规则匹配是线性的,规则数量增多后性能下降明显;每次更新规则都需要重建整个规则集。功能扩展困难
新功能往往需要添加新的匹配模块或目标,内核和用户空间都要改。语法碎片化
IPv4 用 iptables,IPv6 用 ip6tables,ARP 用 arptables,ebtables 又是另一套,命令不统一。
nftables 的优势:
- 统一框架:IPv4、IPv6、ARP、bridge 等使用同一套工具和语法
- 规则编译成类似字节码,匹配性能更好
- 支持真正的原子性更新(一次提交全部生效)
- 语法更接近高级语言,支持变量、集合、映射等
- 内核接口更简洁,用户空间工具(nft)功能更强
因此,内核社区和各大发行版把 nftables 作为长期方向。
19.2. iptables-legacy
iptables-legacy 是传统的 iptables 实现,底层直接操作 xtables / ip_tables 等内核模块。
特点:
- 规则存储在传统的 iptables 框架中
- 与老系统、老脚本完全兼容
- 性能和功能已基本停滞
- 在新发行版中仍可通过
iptables-legacy命令使用
查看是否在使用 legacy:
1 | iptables-legacy -V |
19.3. iptables-nft
iptables-nft 是一个兼容层:
- 用户继续使用熟悉的 iptables 命令和语法
- 底层把规则转换成 nftables 规则
- 真正在内核中生效的是 nftables
查看方式:
Bash
1 | iptables -V |
重要提醒:
- iptables -L 看到的是兼容层“翻译”后的视图,不一定完整反映真实 nft 规则
- 真正权威的规则查看方式是 nft list ruleset
- 不要把 iptables-legacy 和 iptables-nft 的规则混用,容易出乱
19.4. nftables 的基本概念
nftables 使用了一套新的术语和结构:
| iptables 概念 | nftables 对应概念 | 说明 |
|---|---|---|
| table | table | 表(按 family 分类:ip、ip6、inet 等) |
| chain | chain | 链 |
| rule | rule | 规则 |
| match + target | expr + verdict | 表达式 + 判决 |
| -A / -I / -D | add / insert / delete | 操作命令 |
基础命令示例:
Bash
1 | # 列出所有规则 |
常用 family:
- ip:仅 IPv4
- ip6:仅 IPv6
- inet:同时支持 IPv4 + IPv6(推荐)
- arp、bridge、netdev 等
19.5. iptables 规则如何迁移
迁移主要有三种方式:
方式一:继续使用 iptables-nft(最平滑)
不改脚本,只是底层换成 nftables。适合暂时不想大改的场景。
方式二:使用翻译工具把规则转换成 nft 语法(推荐学习)
见下一节 iptables-translate。
方式三:彻底重写为原生 nftables 规则
长期维护成本最低,也能充分发挥 nftables 的优势(集合、映射、原子更新等)。
迁移前必做:
Bash
1 | # 备份现有规则 |
19.6. iptables-translate
iptables-translate 是官方提供的翻译工具,能把 iptables 命令转换成对应的 nft 语法。
Bash
1 | # 翻译单条命令 |
注意:
- 翻译结果通常可用,但复杂规则(尤其是多模块组合、自定义链)可能需要人工调整
- 翻译后建议用 nft list ruleset 检查,并做流量测试
- 部分旧模块在 nftables 中已有更好的替代写法(如用 set 替代 ipset 的某些用法)
19.7. iptables 与 nftables 对照
| 功能 / 操作 | iptables 写法 | nftables 写法(inet family 示例) |
|---|---|---|
| 允许 SSH | iptables -A INPUT -p tcp –dport 22 -j ACCEPT | nft add rule inet filter input tcp dport 22 accept |
| 允许已建立连接 | -m conntrack –ctstate ESTABLISHED,RELATED -j ACCEPT | ct state established,related accept |
| 丢弃非法包 | -m conntrack –ctstate INVALID -j DROP | ct state invalid drop |
| DNAT | -t nat -A PREROUTING -p tcp –dport 80 -j DNAT –to-destination 192.168.1.100:8080 | add rule inet nat prerouting tcp dport 80 dnat to 192.168.1.100:8080 |
| MASQUERADE | -t nat -A POSTROUTING -o eth0 -j MASQUERADE | add rule inet nat postrouting oifname “eth0” masquerade |
| 限制来源 IP | -s 192.168.1.0/24 | ip saddr 192.168.1.0/24 |
| 计数器 | 默认自带,-v 查看 | 需显式加 counter |
| 查看规则 | iptables -L -n -v | nft list ruleset |
| 保存规则 | iptables-save > file | nft list ruleset > file |
| 恢复规则 | iptables-restore < file | nft -f file |
更现代的 nftables 写法优势示例(使用集合):
Bash
1 | # 定义端口集合 |
这在 iptables 中需要 multiport 或多条规则才能实现。
本节核心总结:
- nftables 是未来,性能更好、语法更统一、功能更强。
- iptables-nft 是兼容层,让老脚本能在新系统上继续跑,但真正生效的是 nft。
- iptables-legacy 是传统实现,新系统中已逐渐边缘化。
- 迁移路径:先用 iptables-translate 翻译 → 人工优化 → 最终转向原生 nft 语法。
- 排障时,以 nft list ruleset 为准,不要只看 iptables -L。
实战建议:
- 新项目直接学习并使用 nftables。
- 老脚本可先跑在 iptables-nft 上,再逐步翻译迁移。
- 生产环境变更前务必备份,并用测试流量验证。
掌握本节内容后,你就能在 iptables 与 nftables 并存的过渡期从容应对,不再被“规则写了却不生效”的问题困扰。
20. 实战:构建 Linux 防火墙
前面所有章节的最终目的,都是为了能在真实场景中快速、安全地写出可用的防火墙规则。
本章给出七个最常见的生产场景完整模板,可直接复制后根据实际环境微调。
通用安全提醒:
- 修改规则前请确保有控制台 / VNC / IPMI 等备用访问手段。
- 先放行 SSH,再设置默认 DROP。
- 每次变更后立刻备份:
iptables-save > /root/iptables-$(date +%F-%H%M).rules
20.1. 基础服务器防火墙
适用于普通应用服务器(只暴露必要端口)。
1 |
|
20.2. Web 服务器
在基础防火墙之上,开放 HTTP/HTTPS,并做简单的连接限制。
Bash
1 | #!/bin/bash |
20.3. NAT 网关
经典共享上网 + 端口转发场景。
Bash
1 | #!/bin/bash |
20.4. Relay Server
中转服务器(只做流量转发,自身不提供业务)。
Bash
1 | #!/bin/bash |
20.5. 多公网 IP 服务器
服务器拥有多个公网 IP,需要控制不同业务使用不同出口。
Bash
1 | #!/bin/bash |
20.6. GOST UDP Relay
GOST / 类似 UDP 中转常见场景(需要特别注意 UDP 超时和源地址)。
Bash
1 | #!/bin/bash |
20.7. 策略路由 + 防火墙
综合示例:不同来源走不同出口,并配合防火墙标记。
Bash
1 | #!/bin/bash |
实战总结与建议
永远先保 SSH,再收紧策略。
所有模板都建议改成脚本,并用 git 管理。
变更后执行:
Bash
1
iptables-save > /root/iptables-latest.rules
高并发或 UDP 场景,记得检查并调大 nf_conntrack_max 和 UDP 超时。
与 Docker / Kubernetes 共存时,优先考虑关闭它们的自动 iptables 管理,改为自己完全控制。
新系统推荐逐步转向 nftables,但以上模板用 iptables-nft 也能正常工作。
把这些模板当作起点,根据实际业务端口、网段、出口情况微调,就能快速构建出稳定、可维护的 Linux 防火墙。
21. 安全实践与最佳实践
写得出规则只是第一步,能长期稳定、安全地运行才是真正的目标。
以下是经过大量生产验证的 iptables 安全与运维最佳实践。
21.1. 默认 DROP
原则:默认拒绝,只允许明确需要的流量。
1 | iptables -P INPUT DROP |
为什么推荐:
- 即使规则写漏,未知流量也会被丢弃
- 大幅减少攻击面
- 符合「最小权限」思想
注意:设置默认 DROP 之前,必须先放行 SSH 和已建立连接,否则容易把自己锁在外面。
21.2. SSH 防锁死
SSH 是运维生命线,必须重点保护。
推荐做法:
先放行已建立连接
Bash
1
iptables -A INPUT -m conntrack --ctstate ESTABLISHED,RELATED -j ACCEPT
再放行 SSH(最好限制来源)
Bash
1
iptables -A INPUT -p tcp --dport 22 -s 你的办公网段或跳板机IP -j ACCEPT
最后才设置默认 DROP
额外防护(可选但强烈推荐):
Bash
1
2
3# 限制单 IP 尝试频率
iptables -A INPUT -p tcp --dport 22 -m conntrack --ctstate NEW \
-m hashlimit --hashlimit-name ssh --hashlimit-above 5/min --hashlimit-mode srcip -j DROP变更前保留备用通道:控制台、VNC、IPMI、云厂商 web 终端等。
使用带超时回滚的脚本(示例思路):
- 应用新规则
- 睡眠 30-60 秒
- 如果 SSH 仍可达则保存,否则自动回滚
21.3. 规则顺序
iptables 规则是从上到下依次匹配,一旦命中终止动作(ACCEPT/DROP/REJECT)就会停止。
推荐顺序:
Bash
1 | 1. 放行 lo(回环) |
原则:
- 越精准、命中率越高的规则越靠前
- 允许规则放在拒绝规则之前
- 日志规则放在最终 DROP 之前
21.4. 最小权限
只开放真正需要的端口和来源。
- 能限制来源 IP/网段就限制
- 能使用 ipset 管理大量 IP 就使用
- 数据库、Redis、内网服务等绝不要直接对公网开放
- 能用内网或 VPN 访问的,就不要暴露到公网
Bash
1 | # 好的例子:只允许内网访问 MySQL |
21.5. 日志控制
日志很有用,但失控的日志会拖垮系统。
最佳实践:
Bash
1 | # 限速记录 |
- 生产环境避免对高流量端口做全量 LOG
- 定期清理或轮转日志
- 重要安全事件可对接 rsyslog 或外部日志系统
21.6. 规则备份
规则只存在于内存,重启即丢失,必须备份。
推荐做法:
Bash
1 | # 每次变更后立刻备份 |
CentOS/RHEL:
Bash
1 | service iptables save |
Ubuntu/Debian:
Bash
1 | apt install iptables-persistent |
21.7. 自动化管理
手动敲命令容易出错,也不利于审计和回滚。
推荐方式:
- 把规则写成脚本,放入版本库(git)
- 使用 Ansible、SaltStack、Puppet 等配置管理工具强制收敛
- 变更走 Code Review
- 重要环境使用「先应用 → 观察 → 再持久化」的流程
- 新系统可逐步转向 nftables,并用同样方式管理
21.8. 不要混用多个防火墙管理器
这是最常见的混乱来源之一。
禁止同时使用:
- firewalld + 手动 iptables
- ufw + 手动 iptables
- Docker 默认 iptables 管理 + 手动大量自定义规则(需特别小心)
- iptables-legacy + iptables-nft 混用
正确做法:
- 选定一个管理方式后坚持到底
- 如果用 firewalld,就只用 firewall-cmd
- 如果用传统 iptables,就停用 firewalld/ufw
- 与 Docker/K8s 共存时,优先考虑关闭它们的自动规则管理,改为自己完全控制
22. 常用命令速查表
查看规则
Bash
1 | iptables -L -n -v --line-numbers # 查看 filter 表(带计数和编号) |
增删改
Bash
1 | iptables -A INPUT ... # 追加 |
默认策略
Bash
1 | iptables -P INPUT DROP |
保存与恢复
Bash
1 | iptables-save > rules.v4 |
连接跟踪
Bash
1 | conntrack -C # 当前连接数 |
ipset
Bash
1 | ipset create whitelist hash:ip |
策略路由
Bash
1 | ip rule show |
日志与排障
Bash
1 | dmesg -w | grep --line-buffered "PREFIX" |
常用模块快捷参考
Bash
1 | -m conntrack --ctstate NEW,ESTABLISHED,RELATED,INVALID |
开关转发与关键参数
Bash
1 | echo 1 > /proc/sys/net/ipv4/ip_forward |
全文总结一句话:
默认拒绝、先放行已建立连接、SSH 永远优先、规则顺序清晰、及时备份、不要混用管理工具。
把这些实践固化到日常操作中,iptables 就能真正成为可靠、可控的安全工具,而不是让人提心吊胆的「定时炸弹」。
iptables 详解:从原理、规则到 NAT 与实战